对象存储擅长处理海量非结构化数据的长期保存,分布式文件系统则更适配高并发读写与低延迟访问场景,两者服务的访问模式截然不同。
很多团队在搭建数据架构时,都会在“选对象存储还是选文件系统”这个问题上卡壳,这不是简单的产品对比,而是对数据访问模式的深度理解问题,搞不清这一点,存储选型就容易走弯路。
对象存储适合存储什么数据
对象存储的核心设计理念是“扁平化”,数据以对象为单位,通过HTTP API进行访问,没有传统目录树的层级概念,这种架构决定了它特别适合处理那些“写一次、读多次”的数据。
典型场景:海量非结构化数据
图片、视频、音频、日志文件、备份归档数据,这些都属于非结构化数据,它们的共同特点是单个文件大小差异大、总量增长快、很少被修改。对象存储的扩展能力非常强,理论上可以存储无限数量的对象,这对数据量动辄达到PB级别的业务来说,是刚需。
访问模式特征:顺序读多,随机写少
对象存储的API设计决定了它不适合频繁的随机写入,你可以轻松地PUT一个对象进去,但要修改对象中间的一部分数据,操作成本就很高,通常的做法是整体覆盖或者创建新版本。对象存储最舒服的工作状态,是数据写入后长时间不再变动,后续主要是读取。
成本优势:按量付费与低频访问
对于冷数据、温数据,对象存储提供了标准、低频、归档等多种存储类型,据行业共识,低频访问存储的成本通常只有标准存储的40%左右,这种价格梯度,让对象存储成为数据生命周期管理的理想底座,比如网盘系统保存用户上传的文档,或者监控系统保存历史录像,都是对象存储的典型用法。
分布式文件系统适合什么场景
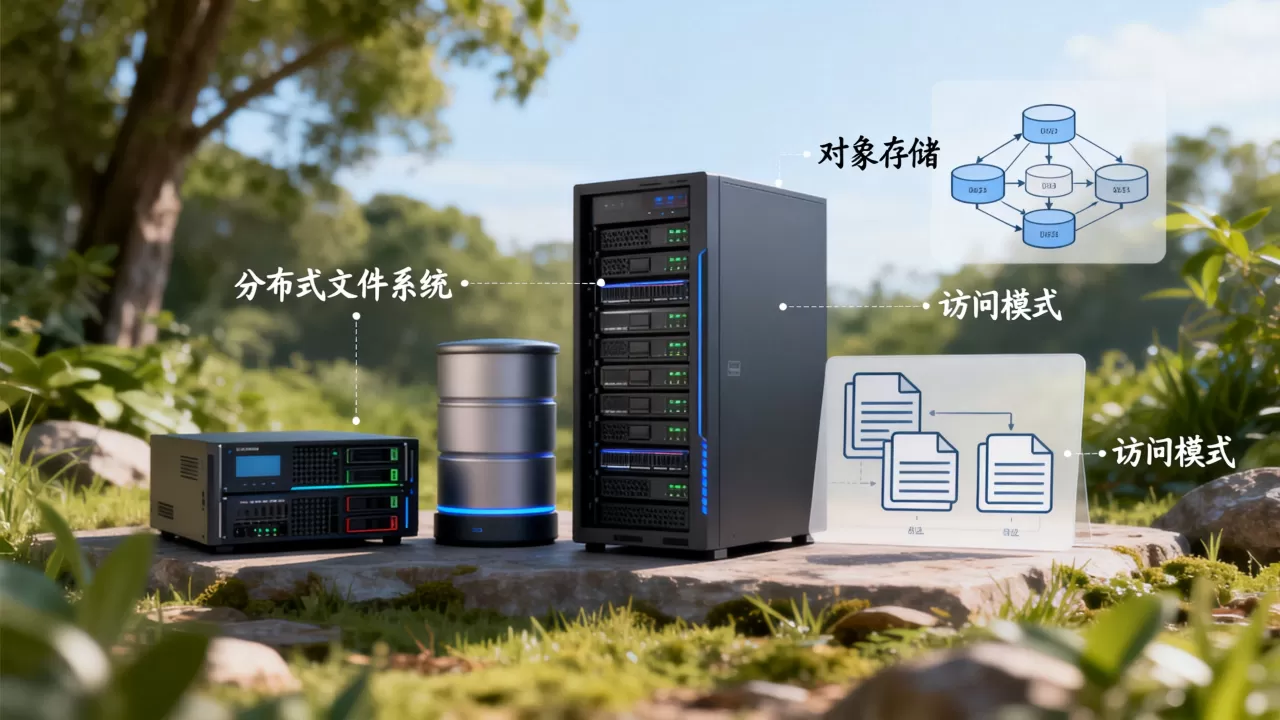
分布式文件系统保留了POSIX语义,也就是说,它看起来用起来都像一个本地文件夹,用户可以像操作本地磁盘一样,执行打开、追加、修改、关闭等操作,这种特性决定了它服务于完全不同的访问模式。
典型场景:高性能计算与在线业务
机器学习训练、视频渲染、气象分析、大型在线事务处理,这些业务的特点是多个计算节点需要同时读写同一批数据。分布式文件系统提供强一致性和文件锁机制,能保证多个客户端并发访问时数据不错乱,业内专家指出,在AI大模型训练场景中,文件系统的缓存命中率直接影响训练效率,这是对象存储难以替代的。
访问模式特征:小文件高并发,随机读写
与对象存储不同,分布式文件系统擅长处理大量小文件的随机读写,比如代码仓库、Web服务静态资源、数据库备份目录,这些场景下,文件系统能够提供毫秒级的响应时间,集群扩容后,性能可以线性提升,这对于追求低延迟的在线服务至关重要。
生态兼容性:无缝对接传统应用
很多企业现有的应用代码是基于文件路径开发的,改用对象存储,往往需要重写代码适配API,而分布式文件系统通过标准挂载协议,可以直接映射到本地目录,这意味着迁移成本极低,应用无需改造即可享受分布式存储的容量和性能红利。
对象存储和分布式文件系统的主要区别
访问模式的不同,直接导致了两者在技术实现和适用边界上的分化,通过对比可以更直观地理解。
| 维度 | 对象存储 | 分布式文件系统 |
|---|---|---|
| 访问协议 | HTTP/HTTPS(RESTful API) | POSIX、NFS、SMB |
| 修改方式 | 整体覆盖或版本更新 | 支持原地随机读写 |
| 一致性 | 最终一致性为主 | 强一致性 |
| 扩展性 | 近乎无限扩展 | 受限于元数据节点规模 |
| 典型场景 | 备份、归档、静态资源 | 高性能计算、在线业务 |
| 单文件大小 | 支持超大文件(TB级) | 适合小文件(MB级) |
数据一致性差异
对象存储为了保证高可用和扩展性,多数采用最终一致性模型,这意味着数据写入后,可能需要短暂的时间才能在所有副本间同步,而分布式文件系统通常提供强一致性,一旦写入成功,立即对所有客户端可见,如果业务对数据一致性要求极高,比如金融交易记录,显然更适合文件系统。
成本模型差异
对象存储的计费模式是按使用量付费,包括存储容量、请求次数、流量,分布式文件系统通常是按集群规模采购,需要预留峰值性能余量。在数据量庞大但访问频率低的场景下,对象存储的总拥有成本明显更低,而在高IOPS场景下,文件系统虽然单价高,但单位性能带来的业务价值也更高。
如何根据访问模式选型
选型不是非此即彼,关键在于分析业务数据的具体访问模式,可以从三个维度来评估。
数据是否频繁变更
- 如果数据写入后极少修改,且以追加为主,优先考虑对象存储。
- 如果数据需要频繁的原地修改、截断、追加,选择分布式文件系统。
访问延迟要求
- 可以接受秒级或百毫秒级延迟,选对象存储。
- 需要毫秒级甚至亚毫秒级延迟,选分布式文件系统。
应用兼容性
- 新开发的应用,可以拥抱API,选对象存储。
- 存量业务系统,特别是基于Linux内核运行的,选分布式文件系统更稳妥。
混合架构是常态
现实中,很多大型系统会同时使用两者,热数据存放在分布式文件系统上,保障业务性能;冷数据定期迁移至对象存储,降低存储成本,这种分层存储策略,兼顾了性能与成本,也是目前业界比较通行的做法。
对象存储与分布式文件系统如何选择
针对具体的业务场景,可以给出更直接的参考路径。
搭建网盘或图床服务
这类业务文件量大、用户访问有明显的冷热分布,建议使用对象存储作为底层存储,配合CDN加速热点文件分发,通过生命周期规则,将超过30天未访问的文件自动转冷,能有效控制成本。
部署大数据分析平台
Hadoop、Spark等框架依赖本地文件系统或HDFS,此时应选择分布式文件系统,并配置合理的副本策略,如果强行将数据放到对象存储上,虽然可以通过S3A协议访问,但计算引擎的随机读取性能会大打折扣。
数据库备份与容灾
数据库备份文件通常是顺序写入、极少读取,将备份文件放入对象存储的归档存储层,成本极低,需要恢复时,解冻后即可下载,不少云厂商提供的备份解决方案,底层就是对象存储。
常见疑问解答
对象存储和分布式文件系统可以互相替代吗?
不能,两者的访问协议和数据模型完全不同,对象存储适合通过API访问的海量非结构化数据,分布式文件系统适合通过路径访问的高并发读写场景,强行替换会导致应用性能下降或架构复杂度上升。
业务快速增长时,哪种存储扩容更方便?
对象存储扩容对业务无感知,容量和性能随购买量自动提升,分布式文件系统扩容通常需要增加节点并执行数据再平衡操作,过程相对复杂,但从另一个角度看,文件系统的扩容可以精确控制性能增量,而对象存储的性能上限受限于API网关和网络带宽。
云上部署和自建机房如何权衡对象存储与文件系统?
云上使用对象存储非常便捷,按量付费且免运维,自建分布式文件系统则需要专业的硬件选型和运维团队,对于中小团队,直接使用云厂商的对象存储服务,搭配少量高性能云盘跑数据库,是性价比较高的方案,对于超大规模数据业务,自建分布式文件系统反而能节省长期成本。