存算分离不一定能降低计算资源的单价,但它通过拆开计算与存储的绑定扩容,多数情况下能减少长期闲置的计算节点数量,从而省下可观的整体计算开销。 如果你的业务数据增长快但计算需求平稳,存算分离通常更划算;如果是低延迟事务库,省下的钱可能被网络损耗抵消。
存算分离省的是什么钱?不是单价,是闲置
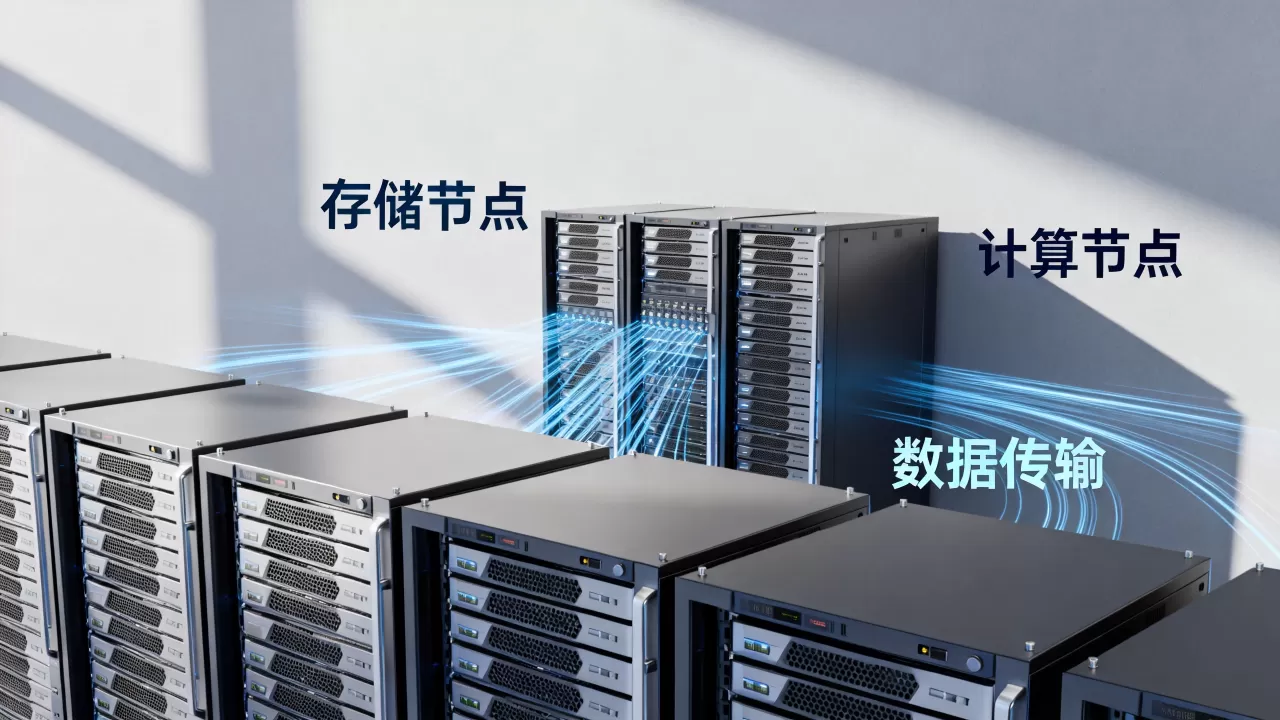
传统数据库架构里,计算和存储捆在一起,要扩容存储,只能加整机节点,CPU、内存、硬盘一起上,问题在于,很多业务的数据量增长远远快过计算需求增长,日志、归档、用户行为数据持续堆积,但分析查询并没有同步暴增,计算节点为了存储扩容而被迫增加,CPU 长期闲置,存算分离就是把存储挪到独立层,计算节点只负责算,存储节点单独扩,这意味着你不需要为了多存 10TB 数据而多买 8 核 32G 的计算资源。
省钱逻辑可以拆成三块:
- 计算节点按需水平伸缩,不跟存储量绑定。
- 存储下沉到对象存储或分布式文件系统,容量单价通常低于持续叠加本地 SSD 的总成本。
- 软件授权浪费减少:不少商业数据库按核数收费,少开核就少授权费。
存算分离的核心不是让单次计算更便宜,而是让你不必为“未来可能用到的计算能力”提前买单。
存算分离架构优缺点:先看清楚再动手
存算分离架构优缺点不能只看宣传,实际落地前,建议先列清楚:
优点:
- 计算和存储独立扩缩,资源利用率更高。
- 大容量存储成本下降,适合数据湖、归档、历史查询。
- 故障隔离更彻底:计算节点挂了不影响存储数据。
缺点:
- 网络变成关键路径,查询延迟可能上升。
- 对象存储有请求费用和流量费,高频小读场景可能反而更贵。
- 需要改造应用或使用支持存算分离的数据库引擎。
存算分离和存算一体哪个好?用业务负载投票
存算分离和存算一体哪个好,没有统一答案,判断标准是业务负载形态。
适合存算分离的场景:
- 离线分析、报表类查询(OLAP):扫描大表但计算节点不需要常驻。
- 数据湖和日志检索:数据量巨大,查询频率低。
- 计算弹性明显:白天跑批,晚上闲置。
- 多个计算集群共享同一份数据。
适合存算一体的场景:
- 核心交易类数据库(OLTP):要求低延迟、高并发点查。
- 本地机房小规模部署:网络带宽和稳定性不足。
- 实时风控、秒级响应系统:远程存储的毫秒级延迟会被放大。
用具体场景来说:假设你有一套电商订单库,主库每天几百万次小事务,走存算分离后每笔事务要跨网络读写数据块,延迟从零点几毫秒变成几毫秒,系统吞吐可能下降,这种情况下省下的计算节点费用可能不够补偿性能损失,反过来,如果你是一家互联网公司的用户行为日志系统,每天新增几十亿条记录,但只跑离线统计分析,存算分离几乎是最自然的选择。
存算分离成本高吗?账单拆开看才清楚
存算分离成本高吗?很多人只看到存储单价下降,忽略了其他账单,要把成本拆成五笔账:
- 计算实例费用:按运行时长计费,弹性伸缩可以省掉夜间和周末的开销。
- 存储容量费用:对象存储通常便宜,但本地缓存盘可能仍需保留。
- 请求费用:每次 PUT、GET、LIST 都收费,高频小文件场景下这笔钱不小。
- 跨可用区流量费用:存算分离后计算和存储可能在不同可用区,跨 AZ 流量按 GB 收费。
- 网络带宽和延迟:内网传输一般不按流量收费,但云厂商会对跨区域或公网流量单独计费。
北京地区的部分云服务商对同区域不同可用区之间的流量有独立定价,改造前一定要确认存储桶和计算集群放在哪个可用区,如果计算节点和存储节点跨可用区,查询延迟增加,同时流量成本上升。
用表格对比三笔显性成本:
| 成本项 | 存算一体 | 存算分离 |
|---|---|---|
| 初始硬件/实例投入 | 高,需整机扩容 | 中等,计算和存储独立购买 |
| 长期资源闲置 | 计算经常闲置 | 计算弹性释放,存储按需增长 |
| 存储扩容单价 | 随新节点叠加 | 相对较低,独立扩展 |
| 隐藏网络/请求成本 | 低 | 需重点评估 |
中小企业上存算分离划算吗?先看两条曲线
中小企业上存算分离划算吗,关键看数据增长曲线和计算需求曲线是否分叉,如果过去半年你的数据量翻倍,但 CPU 平均利用率长期不足三成,那就比较典型,这种情况继续用存算一体,你会为了存储扩张被迫增加计算节点,花钱买闲置 CPU。
实操判断方法:
- 登录服务器执行
df -h查看存储使用量,记录每周增长。 - 执行
sar -u或top查看 CPU 平均负载。 - 如果存储月增长超过两成,而 CPU 平均利用率长期低于四成,可以考虑存算分离。
- 如果业务是高频事务型,CPU 利用率稳定在六成以上,存算分离可能省不了钱。
怎么判断你的集群该不该拆:三步实操
第一步,统计资源利用率,使用监控工具拉取过去 30 天的 CPU、内存、磁盘 IO 和存储容量数据,云环境可以用云监控 API 导出 CSV。
第二步,画出增长趋势,把存储增长曲线和计算需求曲线放在同一张图里,观察它们是否明显分叉,分叉越大,存算分离收益越高。
第三步,做小范围成本测算,选一个非核心库或历史库,迁移到存算分离架构,运行两周,对比两种模式下的账单和查询延迟。
示例命令:
# 查看节点 CPU 使用率
kubectl top nodes
# 查看磁盘使用
df -h
# 导出云监控指标(以某云为例)
aliyun cms DescribeMetricList --Namespace acs_ecs_dashboard --MetricName CPUUtilization
这样能得到可验证的数据,而不是拍脑袋决定。
云上存算分离改造费用怎么预估:五笔账
云上改造前,先预估这五笔钱:
- 计算资源重估:分离后计算节点可以减少多少核数,按减少的核数乘以单价,就是每月节省额。
- 存储迁移成本:数据从本地盘迁移到对象存储需要时间和带宽,迁移期间可能有双份存储费用。
- 请求费用模拟:用一周的访问日志估一下读请求频率,乘以对象存储的每万次请求单价。
- 跨可用区流量:确认计算集群和存储桶的可用区位置,如果跨区,按预估流量计算。
- 改造开发成本:应用连接方式、数据格式、查询引擎可能需要调整,这部分人工成本不能忽略。
为什么有人上了存算分离反而更贵
存算分离不是万能省钱术,有些团队改造后发现账单不降反升,主要原因集中在几点:
- 对象存储请求过于频繁:大量小文件读操作,每次 GET 都计费,累计费用超过节省的计算成本。
- 跨可用区流量没算:存储桶和计算集群没放同一个可用区,流量费悄悄增加。
- 查询延迟放大后加缓存:为了弥补远程存储延迟,又增加一层 Redis 或本地缓存,额外成本抵消了收益。
- 应用层没改:业务代码仍按本地盘方式频繁访问,导致不必要的 IO 放大。
存算分离的省钱效果高度依赖架构设计和应用适配。
容易被忽略的隐性成本与延迟代价
存算分离把存储放在网络另一端,网络就成了每一条查询的必经之路,对于大查询,网络延迟相对影响小;对于小查询,网络往返可能占总响应时间的一半以上,业内专家指出,很多企业在评估存算分离时只比较存储单价,却忽略了延迟敏感型业务的性能损耗,如果你的应用有大量毫秒级点查,存算分离带来的延迟增加可能会让前端体验变差。
对象存储通常不是强一致性读,部分实现存在最终一致性问题,虽然主流云厂商已经提供强一致性选项,但请求路径变长,小 IO 性能会掉,压缩、解压、编码操作也会消耗额外 CPU,有时计算节省被这些辅助操作抵消。
存算分离真的能帮我们省下不少计算开销吗?相关问答
存算分离和存算一体哪个好?
取决业务类型,大容量分析、日志、数据湖场景下存算分离好,高频交易、低延迟点查场景下存算一体更稳定,先看业务负载,再决定架构。
存算分离架构优缺点有哪些?
优点是计算存储独立扩缩、容量成本低、故障隔离,缺点是网络延迟增加、请求费用和跨可用区流量成本、小 IO 性能可能下降。
存算分离成本高吗?
不一定高,如果计算需求弹性大、数据量大但查询频率低,总成本通常下降,如果业务高频小读、跨可用区部署或请求量巨大,成本可能反超存算一体,对象存储按容量、请求次数和流量分别计费,这些都要纳入计算。