实时大屏背后的流处理链路,核心是由数据采集、消息队列、流计算引擎、结果存储和前端渲染五层组成,搭建的关键在于根据数据量级和延迟要求选对组件,并处理好从源头到展示的每一环衔接。 很多人以为实时大屏就是前端画图,其实真正吃功夫的是后端这条链路,今天咱们就把这条链路从数据产生到屏幕渲染,一层层拆开看。
实时大屏流处理链路的基本构成
流处理链路听起来高大上,拆开看就是一个数据“管道工”的活,数据从业务系统产生,经过采集、排队、计算、存储,最后推给浏览器渲染,每一层都有自己该干的活,也有常见的坑。
数据采集:离源头越近,越要稳
采集层负责把数据库日志、接口调用记录、埋点数据等搬进管道,常用工具有 Flume、Logstash,也有用 Flink CDC 直接抓取数据库变更的,采集层最怕丢数据,所以一般都会加确认机制,Kafka 的 ack 设置为 all,确保消息真正写入副本才算成功,这一层的配置要点是并行度合理,不要刚启动就把数据库连接池打满。
消息队列:削峰填谷的缓冲带
采集到的数据会进入消息队列,最常用的是 Kafka,其次是 Pulsar 和 RocketMQ,消息队列的价值在于解耦和削峰,比如电商大促那一秒涌入几百倍正常流量,流计算引擎可能扛不住,队列先存下来,让计算引擎按自己的节奏消费,选型时主要看吞吐量和消息延迟,Kafka 在吞吐量上很能打,Pulsar 则在多租户和低延迟场景更有优势。
流计算:实时逻辑的跑车
这是整个链路的核心,当前主流选择是 Apache Flink,Spark Streaming 和 Storm 也有应用,但 Flink 凭借精确一次语义和原生流处理能力成为事实标准,流计算引擎里跑着你的业务逻辑,比如统计每分钟的订单金额、计算 TopN 商品、识别异常设备等,行业共识认为 Flink 在流处理生态上领先一步,尤其是它支持事件时间和窗口计算,处理乱序数据非常友好。
存储与查询:给大屏一个够快的“内存”
计算结果不能只放在流引擎里,得落到一个能快速查询的存储中,常用的有 ClickHouse、Doris、Elasticsearch,以及 Redis,ClickHouse 和 Doris 适合聚合查询,ES 适合全文检索和日志场景,Redis 则用于缓存热点数据,这一层的核心指标是查询延迟,大屏轮询或者交互式下钻,通常要求 p95 查询在百毫秒以内。
前端渲染:最后一公里的推送
最后一步是把数据从后端推到浏览器大屏上,常见方案是 WebSocket 推送,或者使用 SSE(Server-Sent Events),如果大屏上数据每秒更新一次,WebSocket 就够了;如果要显示毫秒级延迟的监控画面,那需要前端直接连接消息队列或者通过 WebSocket 网关订阅,这里一个容易踩的坑是前端渲染性能,数据更新频率过高会导致 DOM 频繁重绘,所以前端通常会做限频,比如每秒最多更新 10 次。
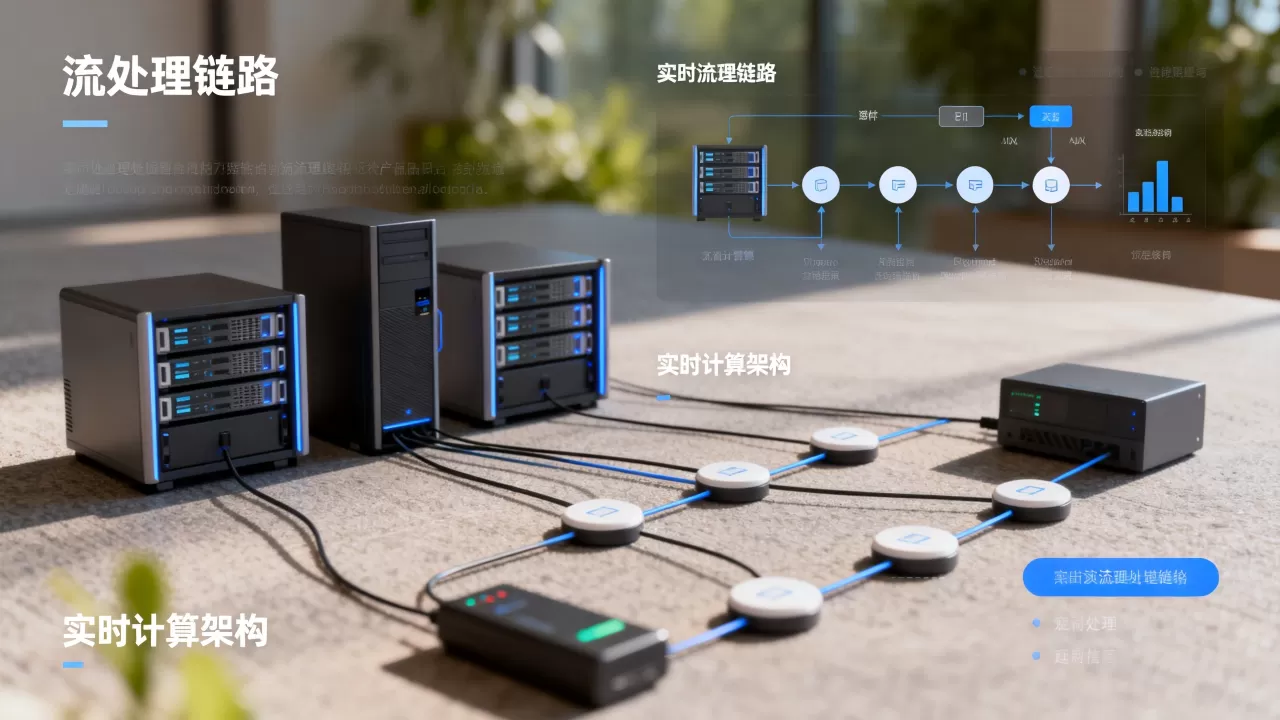
实时大屏流处理架构方案对比:哪种适合你的场景?
聊完基本构成,你会发现组件选型不是固定的,有人喜欢全开源自建,有人倾向于云上托管,还有些场景只需要简单轮询,不需要真流计算,这里对比几种常见方案,方便你按场景对号入座。
自建开源组件与云上托管服务的对比
自建意味着你从 Kafka、Flink、ClickHouse 到前端全部自己部署运维,云上托管则是用云厂商提供的消息队列、流计算服务,对比来看:
| 对比维度 | 自建开源组件 | 云上托管服务 |
|---|---|---|
| 初期成本 | 只有服务器成本,软件免费 | 按量计费,可能贵一些 |
| 运维工作量 | 大,Kafka 和 Flink 都要自己调优 | 小,云平台帮你管版本和容灾 |
| 弹性扩容 | 需要手动扩容,且需要预留资源 | 可以秒级自动弹性 |
| 长期成本 | 规模小时便宜,规模大时运维人力成本高 | 规模大时可能更划算,因为不用招专门运维 |
如果你是一个中小团队,没有专职的大数据运维,云上托管会更省心;如果你对数据主权和成本有严格要求,且团队里有熟悉 Flink 的人,自建也没问题。
延迟与吞吐的取舍:Lambda 还是 Kappa
架构层面,还有一种常见对比是 Lambda 架构和 Kappa 架构,Lambda 架构同时维护批处理和流处理两条链路,确保数据准确,但开发维护成本高,Kappa 架构只保留流处理,通过重放消息来修正数据,更适合大多数实时大屏场景。
在实际项目中,大屏数据很少需要精确到历史全量重算,Kappa 架构更受欢迎,除非你的业务同时要跑离线报表和实时大屏,否则没必要引入整套 Lambda。
从零搭一条实时大屏链路:分步实操
知道了架构,还得能落地,下面以最常见的电商订单实时大屏为例,给你一套可执行的操作路径。
第一步:数据源接入与采集配置
假设你的订单数据在 MySQL 里,想要实时同步到 Kafka,可以用 Flink CDC,先添加 mysql-cdc 依赖,然后写一段简单配置:
CREATE TABLE order_src (
    id INT,
    order_amount DECIMAL(10, 2),
    order_time TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'mysql-cdc',
    'hostname' = 'localhost',
    'port' = '3306',
    'username' = 'root',
    'password' = '123456',
    'database-name' = 'shop',
    'table-name' = 'orders'
);
采集层配置好后,可以去 Kafka 里确认消息是否进入 topic。
第二步:定义消息队列 Topic
在 Kafka 中创建一个 topic,建议按照业务域命名,order_topic,分区数设置为与后续 Flink 并行度一致,8 个分区,如果订单量很大,可以按订单 ID 或用户 ID 作为 key 以保证同一订单的顺序性。
kafka-topics.sh --create --topic order_topic --partitions 8 --replication-factor 2 --bootstrap-server kafka:9092
第三步:用 Flink SQL 做流计算
Flink SQL 可以让你不用写复杂的 Java 代码,先创建 Kafka 来源表和 ClickHouse 结果表,然后写一条聚合查询:
CREATE TABLE order_flow (
    id INT,
    order_amount DECIMAL(10, 2),
    order_time TIMESTAMP(3),
    WATERMARK FOR order_time AS order_time - INTERVAL '5' SECOND
) WITH (
    'connector' = 'kafka',
    'topic' = 'order_topic',
    'properties.bootstrap.servers' = 'kafka:9092',
    'format' = 'json'
);
CREATE TABLE order_agg (
    minute_str STRING,
    total_amount DECIMAL(10, 2),
    order_cnt BIGINT
) WITH (
    'connector' = 'clickhouse',
    'url' = 'clickhouse://localhost:8123',
    'table-name' = 'order_agg'
);
INSERT INTO order_agg
SELECT
    DATE_FORMAT(order_time, 'yyyy-MM-dd HH:mm') AS minute_str,
    SUM(order_amount) AS total_amount,
    COUNT() AS order_cnt
FROM order_flow
GROUP BY DATE_FORMAT(order_time, 'yyyy-MM-dd HH:mm');
这里用事件时间加 5 秒水印处理乱序数据,实际生产环境建议把 Flink SQL 提交到任务集群,flink run -c 或者用 SQL Client。
第四步:结果入仓入市
ClickHouse 建表时要注意分片和排序键,比如订单聚合表按分钟字符串做排序键,这样按分钟查询很快,也可以同时把明细数据写入 Elasticsearch,用于大屏上的搜索和下钻。
第五步:后端接口与 WebSocket 推送
大屏后端可以写一个简单的 WebSocket 服务,每秒从 ClickHouse 查一次最新聚合结果,然后推送给前端,注意不要并发查询同一个接口,导致数据库压力大,用缓存或者定时查询,将结果存在内存中,每次推送直接读内存。
实时大屏开发要多少钱?成本拆解
这是一个乙方和甲方都很关心的问题,价格没法给一个精确数字,但可以拆解一下成本构成。
服务器资源成本
如果是自建,你需要至少三台服务器跑 Kafka,三台跑 Flink,再加一台 ClickHouse,合计七台起步,按照较为常见的 4 核 16G 云主机配置,每台月成本在几百到上千元不等,整体每个月开销在几千元左右,如果走云上托管,流计算和消息队列按 CU 和分区计费,一天几十块到几百块都有可能,取决于吞吐量,小数据量场景可以用单机版,成本更低。
开发与运维人力成本
这部分比服务器更贵,一套完整链路的开发,包括数据采集、流计算、后端接口、前端大屏,往往需要两到三人配合,开发周期在两周到一个月,按市场价格,人力成本几万元到十几万元不等,业内专家指出,实时大屏项目的成本大头往往不在硬件,而在持续调优,特别是 Flink 任务的稳定性、数据延迟优化、告警排查,这些都会消耗大量时间。
如果预算有限,也可以先用开源大屏工具配合简单的定时查询,假装是实时大屏,但真正的秒级响应,还是得走流处理链路。
不同场景下的链路落地差异
方案选型脱离不了业务场景,同样是实时大屏,电商和工业监控的链路侧重点完全不同。
电商大屏:流量洪峰下的弹性
电商大屏在促销节点会面临流量暴涨,链路需要快速扩容,Kafka 的分区数、Flink 的并行度都要能动态调整,一般建议采用云上托管,因为它天然支持弹性伸缩,电商大屏对准确性要求很高,不能因为背压而丢数据。
工业监控大屏:低延迟是生命线
工厂设备数据通过传感器上报,延迟超过几秒就可能漏掉故障,这种场景下,消息队列要选低延迟的,Pulsar 或者 RocketMQ,流计算逻辑要尽量简单,少做复杂聚合,直接透传或简单过滤,存储上直接用 Redis,最多加一层时序数据库,InfluxDB。
一线城市项目:北京上海的实时大屏需求特点
在北京上海做这类项目,甲方通常更关注系统稳定性与交付速度,比如上海某零售品牌的运营大屏,要求跨区域门店数据在 3 秒内同步,链路里就会用到专线连接和边缘采集节点,北京的项目则更多涉及政务或金融,安全等保要求高,自建比重更大,地域差异不影响技术选型,但会影响服务商提供的合规方案和响应时间。
关于实时大屏流处理链路的常见问题
实时大屏的流处理链路和准实时有什么区别?
流处理链路是事件驱动,数据一产生就进入计算,端到端延迟通常在秒级甚至毫秒级,准实时一般指每分钟或每几分钟跑一次批任务,比如用 Airflow 定时查询数据再写回大屏存储,两者的本质区别在于计算模式,真正的流处理是持续不断的,而准实时是间隙性的。
实时大屏数据延迟一般怎么优化?
延迟可能出现在采集、队列、计算、存储、前端五层,最常见的优化手段有三点:第一,调整 Flink 的并行度和 buffer 超时时间,taskmanager.memory.size 和 execution.buffer.timeout 参数直接影响吞吐和延迟;第二,ClickHouse 查询要避免大表扫描,建好分区后使用预聚合表;第三,前端不要实时请求后端接口,改为 WebSocket 推送,减少 HTTP 连接开销,逐层排查耗时,才是降低延迟的正道。