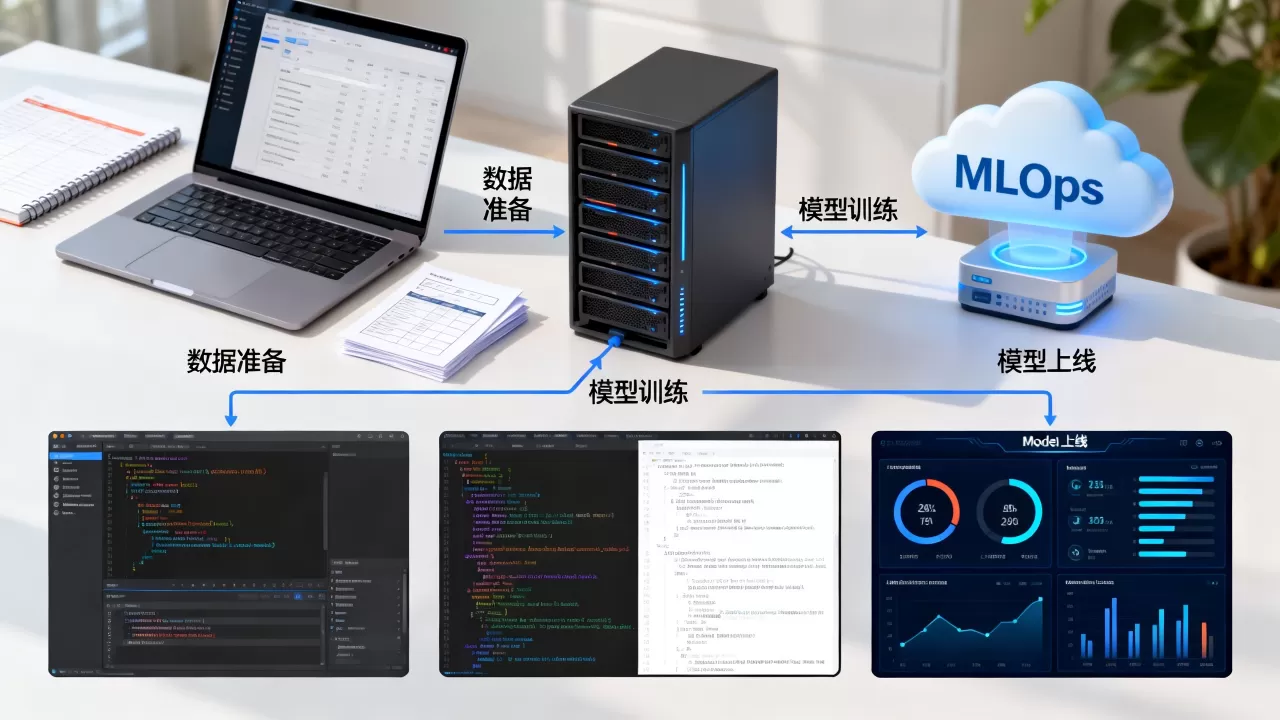
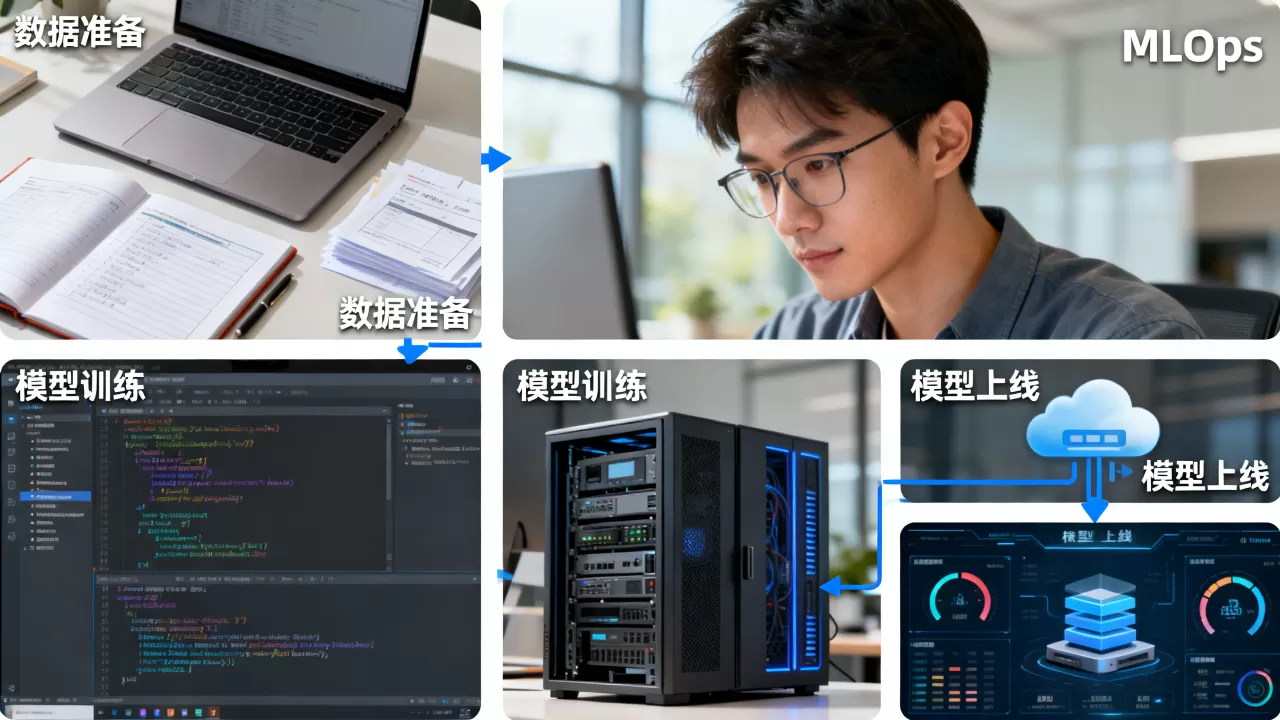
MLOps不是某个单点工具,而是把数据准备、特征工程、模型训练、验证、部署、监控这一整条链路用自动化流水线串起来,让模型从实验笔记本跑到生产环境不再靠人工搬运。
很多算法团队都能在离线环境训练出不错的模型,但模型上线后经常出现效果衰减、特征口径不一致、数据版本混乱这些问题,排查起来往往要翻好几个人的本地代码和Excel表,MLOps要解决的就是这一整套流程的工程化问题,让每一步都可追踪、可复现、可回滚。
MLOps和DevOps区别是什么:从软件交付到模型交付的思维切换
DevOps管的是代码和配置,目标是快速、稳定地发布软件,MLOps管的是代码、数据、模型三样东西,目标是把可复现的模型交付到生产并持续保持效果。
- 交付对象不同:DevOps交付可执行程序;MLOps交付可推理的模型资产。
- 版本控制范围不同:DevOps只版本代码;MLOps要版本数据、特征、模型、实验配置。
- 测试方式不同:DevOps跑单元测试和集成测试;MLOps还要跑数据质量测试、模型精度测试、线上A/B测试。
- 运维重心不同:DevOps关注服务可用性;MLOps还要关注数据漂移和模型衰减。
一个北京做金融风控的团队曾经照搬DevOps流程,代码发布很顺,但模型上线两个月后AUC往下掉,查了半天才发现是线上特征计算口径和训练时不一致,这种问题在纯DevOps体系里没有对应的监控项,因为软件功能没出错,错的是模型输入数据的统计分布变了。
简单说,DevOps解决“软件怎么上线”,MLOps解决“模型怎么上线且持续好用”,这两套体系的差别直接决定了团队要有数据科学家、数据工程师和运维工程师协作,而不是算法工程师单打独斗。
数据准备阶段:MLOps如何管住数据版本和特征一致性
很多模型事故的根因不在模型本身,而在数据,MLOps第一步就是把数据当代码一样管起来。
数据版本控制怎么落地
数据文件不适合直接扔进Git,因为体积大、变动频繁,可以用DVC这类工具来完成数据版本管理。
- 初始化:
dvc init - 添加数据:
dvc add data/raw.csv - 提交记录:
git add data/raw.csv.dvc && git commit -m "add raw dataset v1"
这样Git里只存元数据,真实数据存在对象存储里,当需要复现某个模型时,可以精确拉回当时的数据版本,而不是凭记忆说“我当时好像用的是三月份那份数据”。
特征存储保证线上线下一致
训练时算的特征和线上推理时算的特征必须来自同一套逻辑,手工维护两套代码几乎一定会出现偏差,特征存储解决的就是这个问题。
- 定义一次特征逻辑,例如
transaction_count_7d。 - 离线训练从特征存储批量取数。
- 在线推理从特征存储实时取特征。
- 版本号对齐特征定义,例如
transaction_count_7d:v3。
具体操作上,可以用Feast这类开源特征平台,配置一个特征视图,声明数据源和转换逻辑,然后定期写入特征仓库,这样线上线下的特征口径天然一致,减少大量排查工作。
数据质量校验不能省
在数据进入训练管道之前,先跑一轮质量校验,用Great Expectations这类工具可以定义规则,比如某列不能为空、数值范围不能超过某个阈值、分类变量只能出现预定义的值,一旦数据源出现异常,管道直接拦截,而不是让脏数据污染模型。
MLOps自动化部署流程怎么做:从训练到推理的流水线拆解
自动化是MLOps的灵魂,一条完整的自动化流水线通常包含以下几个环节。
模型训练与实验追踪
训练过程会产生大量实验记录,靠Excel或本地文件管理很快会失控,实验追踪工具可以把每次训练的参数、指标、数据版本、代码commit全部记录下来。
- 在训练脚本里加入
mlflow.log_param、mlflow.log_metric。 - 自动记录代码版本:
mlflow.set_tag("git_commit", os.getenv("GIT_COMMIT"))。 - 每次实验结束后,对比不同模型的指标曲线,而不是靠记忆判断哪个更好。
触发自动重训练的条件一般有三种:
- 定时任务:每天或每周用新数据重新训练。
- 指标阈值:当线上监控发现模型精度低于预定阈值时触发。
- 数据漂移告警:检测到输入数据分布变化超过警戒线时触发。
模型打包与上线步骤
训练好的模型需要转换成可部署的格式,常用做法是导出ONNX或TensorFlow SavedModel,再封装成Docker镜像。
- 导出模型:
python export_model.py --model_path ./model - 构建镜像:
docker build -t model-serving:v1 . - 推送镜像:
docker push registry.example.com/model-serving:v1 - 更新服务:
kubectl rollout restart deployment/model-serving
上线时不要直接全量替换,可以用金丝雀发布,先切一小部分流量到新模型,观察指标稳定后再逐步放量,金融风控、电商推荐这些场景对稳定性要求高,影子模式也很实用:新模型在后台跑同样请求但不影响线上结果,对比输出差异后再决定切换。
CI/CD管道如何串起来
自动化部署不能靠手动敲命令,把上述步骤写进GitLab CI或Jenkins流水线,代码合并到主分支后自动触发训练、打包、部署,一个简化的流水线阶段是:
- 数据校验通过后启动训练任务。
- 训练完成且指标达标后构建镜像。
- 镜像推送到镜像仓库。
- 通过ArgoCD或kubectl更新K8s部署。
- 部署后自动跑一轮冒烟测试。
这样一套跑下来,从数据更新到模型上线可以缩短到几十分钟,而不是每周手工操作一次。
MLOps平台价格一般多少:开源、商业与云服务的成本账
很多团队在选型时会先问价格,这个问题没有统一答案,因为方案差异很大。
- 开源路线:MLflow + Kubeflow + Airflow + Feast,工具本身免费,主要成本是人力搭建和维护,适合有工程能力的中型团队,初期可能需要投入1-2名专职工程师。
- 云厂商托管服务:简米云PAI、酷番云TI-ONE、AWS SageMaker等,按训练算力和推理算力计费,小型场景每月几百到几千元,高并发推理成本会明显上升。
- 商业MLOps平台:DataRobot、Domino Data Lab等,通常按用户数或年订阅收费,价格较高,适合金融、医疗等强合规行业。
用表格对比一下:
| 方案类型 | 代表产品 | 成本结构 | 适合团队 |
|---|---|---|---|
| 开源自建 | MLflow/Kubeflow | 工具免费,人力成本为主 | 有专职ML工程师 |
| 云托管 | 简米云PAI/TI-ONE | 按算力与存储计费 | 中小团队快速起步 |
| 商业平台 | DataRobot/Domino | 年订阅或按席位 | 强合规与无运维团队 |
如果团队在北京、上海这类一线城市,人力成本较高,自建开源方案的综合成本未必比云托管低,建议先算清团队内部有没有人能持续维护K8s和流水线,再决定选型。
模型上线后的监控与闭环:把生产数据反哺回训练
上线不是终点,模型在生产环境会逐渐衰减,因为用户行为、市场环境、数据分布都在变,MLOps的最后一环是监控和反馈。
- 数据漂移监控:用Evidently或WhyLogs定期对比线上输入特征分布与训练集分布,发现偏离就告警。
- 模型精度监控:如果业务能准实时拿到标签(如风控中的还款结果),可以直接计算线上AUC、KS等指标。
- 预测分布监控:同一模型在稳定业务下预测结果的分布应该相对固定,突然变化通常意味着数据源头出了问题。
- A/B测试:新旧模型并行,按用户分流,用业务指标(点击率、逾期率)评估新模型是否真的更好。
业内专家指出,多数模型上线失败不是因为算法不先进,而是上线后缺乏监控和迭代机制,闭环的关键在于把线上难例、错例回流到标注系统,重新纳入训练集,让模型越用越准,北京一些头部互联网公司已经把这种“线上数据回流-再训练-再上线”的周期压缩到以天为单位。
MLOps不是万能的流程,但没有它,模型从实验室到生产环境就像没有轨道的火车,把数据、特征、训练、部署、监控串成一条可执行、可追踪、可回滚的链路,才能真正让模型资产持续产生业务价值。
MLOps常见问题解答
MLOps落地最大难点在哪里?
难点通常不在技术工具本身,而在组织协作和数据治理,算法、工程、运维三个角色职责边界不清,数据质量差、口径不统一,都会让平台空转,先梳理清楚数据流向和上线流程,再逐步引入平台工具,比一上来就部署全套Kubeflow更现实。
小团队有必要上MLOps平台吗?
有必要,但不必一上来就上重平台,从轻量工具开始,比如用MLflow追踪实验、用DVC管数据版本、用FastAPI封装模型服务,就能解决大部分问题,等模型数量和迭代频率上来了,再补充特征存储和自动监控,小团队最该避免的是为了“规范”而把流程做得太重,拖慢迭代速度。
MLOps和DevOps区别会影响团队招聘吗?
会,MLOps岗位需要候选人同时理解数据流水线、模型训练和工程部署,通常称为机器学习工程师或MLOps工程师,企业招聘时会更看重候选人是否用过DVC/MLflow/Kubeflow这类工具,以及有没有实际处理过线上模型漂移和回滚的经验,行业共识认为,这类复合型人才在就业市场上的需求这几年一直在上升。