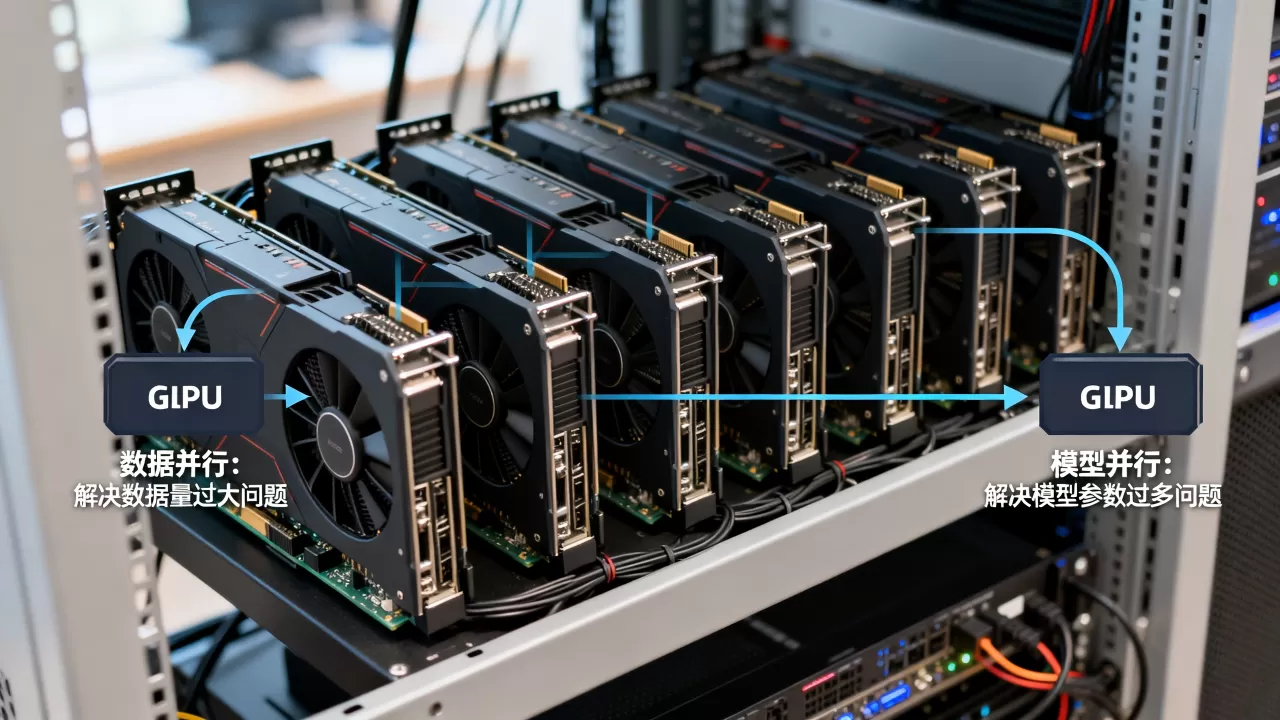
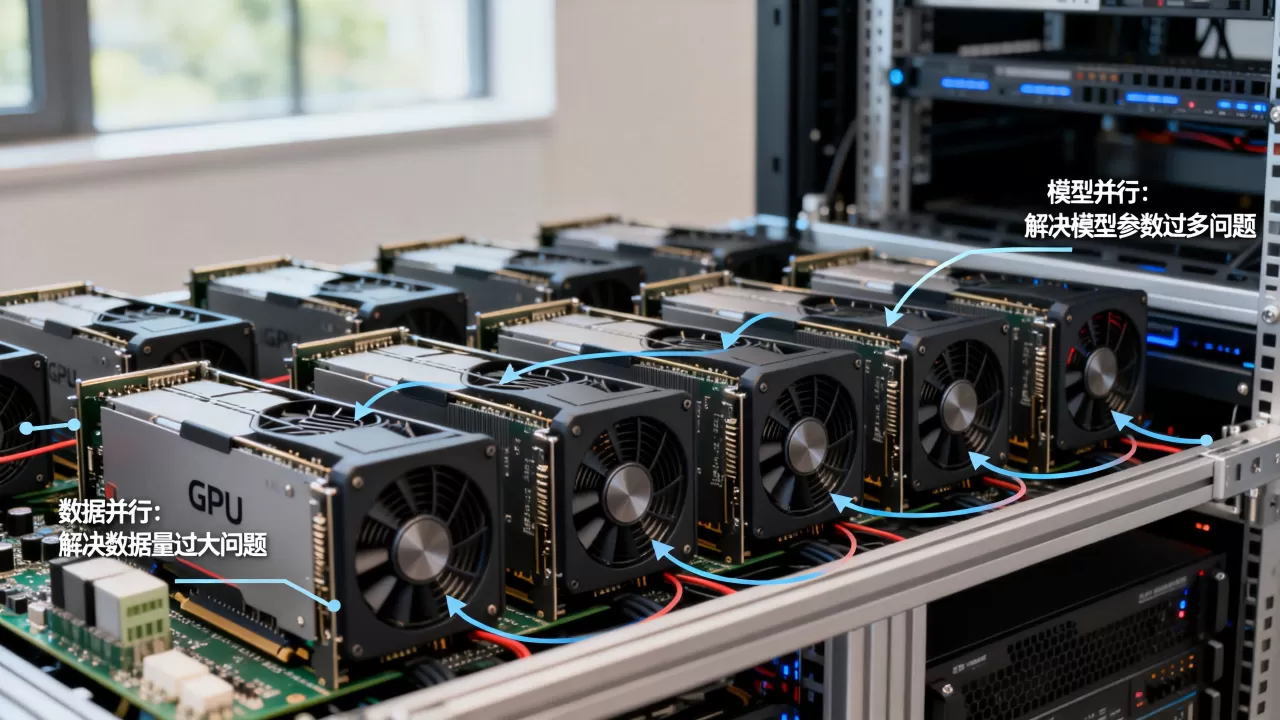
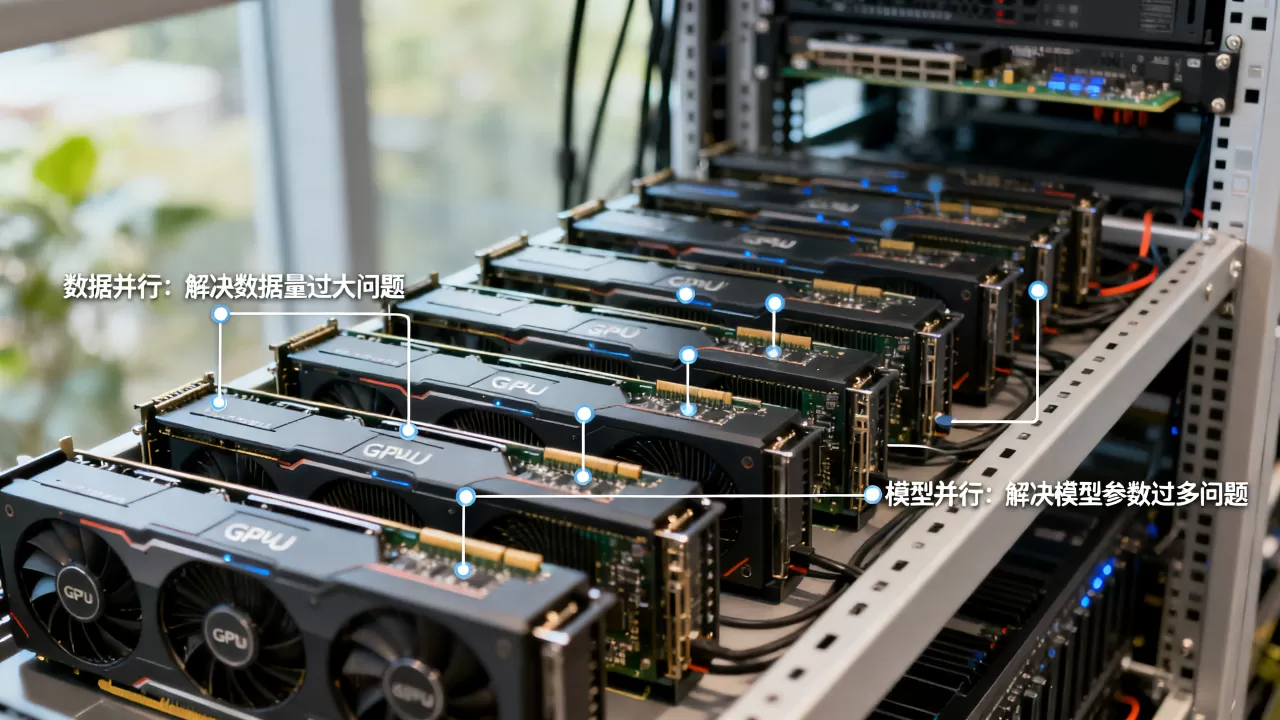
多卡训练里,数据并行解决的是“训练太慢”,模型并行解决的是“单卡显存放不下模型”,中小模型优先数据并行,大模型必须上模型并行,实际大模型训练通常两者叠加使用。
数据并行和模型并行有什么区别?本质是“切数据”和“切模型”
很多人在第一次接触分布式训练时,会把数据并行和模型并行混在一起,其实区分它们只需要看一个动作:切的是数据,还是切的是模型。
数据并行:同一份模型,每人吃不同数据
数据并行的前提是单张显卡能完整放下这个模型,比如训练一个ResNet-50或者BERT-base,单卡显存完全够用,但问题在于数据量太大,一张卡跑一个epoch要很久。
这时候的做法是把模型完整复制到每一张GPU上,然后把一个batch的数据切成几份,每张卡拿一份,每张卡各自做前向传播、反向传播,算出梯度,关键步骤来了:所有卡的梯度要做一个AllReduce操作,取平均后再更新参数,因为每张卡上的模型结构完全一样,只要梯度同步了,参数就能保持一致。
在PyTorch里,这通常用DistributedDataParallel实现,核心操作路径是这样:
import torch.distributed as dist
from torch.nn.parallel import DistributedDataParallel as DDP
dist.init_process_group(backend='nccl')
model = model.to(device)
model = DDP(model, device_ids=[local_rank])
之后每张卡正常跑训练循环,只是数据加载器要用DistributedSampler把数据分片。
数据并行解决的核心问题是计算吞吐,原来一张卡处理一个batch,现在四张卡同时处理四个batch的大小,训练速度接近线性提升,但它不解决显存问题,因为每张卡上的模型占用是一样的,甚至还要额外留出梯度同步的通信缓冲区。
模型并行:同一个模型,每人扛一段结构
当模型大到单卡显存根本放不下时,数据并行就失效了,比如一个参数量达到百亿级别的模型,光权重本身就可能超过单卡显存,更别说优化器状态和中间激活值,这时候必须把模型本身切开,分到多张卡上。
模型并行的逻辑是:同一份数据依次流过不同的GPU,每张卡只存模型的一部分,比如一个Transformer有48层,可以把前24层放在GPU 0,后24层放在GPU 1,输入数据先经过GPU 0,算完把中间结果传给GPU 1,再继续算,这就叫流水线并行。
还有一种更细的切法叫
张量并行,它把单层内部的大矩阵乘法按行列切开,分给不同卡计算,比如一个线性层权重矩阵是[4096, 4096],可以按列切成两块[4096, 2048]分别放在两张卡上,输入同时喂给两张卡,最后把结果拼接,Megatron-LM就是这种思路的典型实现。
模型并行解决的核心问题是显存上限,一个单卡放不下的模型,切开之后可以放进多张卡,但代价是通信开销变大,因为每前向或反向传播一次,卡与卡之间就要传中间激活和梯度,如果卡间带宽不够,训练速度会明显下降。
一张表看懂两种并行的差异
| 对比维度 | 数据并行 | 模型并行 |
|---|---|---|
| 切分对象 | 数据batch | 模型结构 |
| 单卡显存要求 | 能完整放下模型 | 只需放下模型的一部分 |
| 解决的痛点 | 训练速度慢 | 显存放不下 |
| 通信频率 | 每个step一次AllReduce | 每个前反向多次 |
| 适用场景 | 中小模型大数据量 | 大模型单卡无法装载 |
多卡训练显存不够怎么办?先判断该用哪种模型并行
显存不够这个报错,做深度学习的人几乎都遇到过,排错路径其实很固定:先看是模型本身太大,还是batch size设得太大。
单卡显存爆了的第一信号
如果训练脚本一启动就报CUDA out of memory,而且发生在模型初始化或者第一个前向传播阶段,多数情况下不是数据并行的锅,而是模型结构本身超过了单卡显存容量,这时候减小batch size基本没用,因为权重都放不下。
如果训练能跑起来,只是batch size稍大就爆显存,那才可能是数据并行场景下的激活值占用问题,可以通过梯度累积或者减小batch size解决。
模型并行的三种主流切法
- 张量并行:把单层内部的大矩阵切开,优点是切分均匀,缺点是通信极频繁,通常需要NVLink这种高速卡间互联,适合单机多卡。
- 流水线并行:按层切开,卡与卡之间只传边界激活,通信量比张量并行小,但容易出现某张卡空闲等待的情况,适合跨机场景。
- ZeRO:微软DeepSpeed提出的做法,严格说它算数据并行的变体,它不切模型结构,而是把优化器状态、梯度、权重参数分片存储,单卡显存下降明显,代价是通信量上升。
具体操作:DeepSpeed配置示例
很多团队在多卡训练显存不够时,第一反应是上DeepSpeed的ZeRO-3,配置并不复杂,核心是写一个JSON文件:
{
  "train_batch_size": 32,
  "zero_optimization": {
    "stage": 3,
    "offload_optimizer": {
      "device": "cpu"
    },
    "offload_param": {
      "device": "cpu"
    }
  }
}
然后用deepspeed启动:
deepspeed --num_gpus=8 train.py --deepspeed_config ds_config.json
这种方式可以让单卡显存压力大幅降低,甚至把优化器状态卸载到CPU内存,但要注意,ZeRO-3的通信量比普通数据并行大很多,如果机器只有PCIe互联,速度会掉得比较明显。
模型并行怎么配置?从单机多卡到多机多卡的实操步骤
模型并行的配置难度明显高于数据并行,数据并行只要几行代码,模型并行往往需要改模型结构或者用专用框架。
环境初始化与通信后端
无论单机还是多机,都建议用NCCL作为通信后端,初始化方式跟数据并行一样:
dist.init_process_group(backend='nccl', init_method='env://')
单机多卡通常直接用localhost,多机则需要设置MASTER_ADDR和MASTER_PORT,这部分如果出错,多半是网络端口不通或者NCCL版本不匹配。
张量并行和流水线并行的典型配置
如果你用的是Hugging Face Transformers,模型并行可以通过device_map自动处理:
from transformers import AutoModelForCausalLM
model = AutoModelForCausalLM.from_pretrained(
    "模型路径",
    device_map="auto",
    torch_dtype="auto"
)
这个操作会自动把不同层分配到不同GPU上,属于流水线并行的一种简化实现,适合推理或者小规模训练。
如果要训练大模型,更常用的组合是Megatron-LM + DeepSpeed,Megatron负责张量并行和流水线并行,DeepSpeed负责ZeRO数据并行,启动命令大致是:
torchrun --nproc_per_node=8 pretrain_gpt.py
  --tensor-model-parallel-size 2
  --pipeline-model-parallel-size 2
  --num-layers 48
  --hidden-size 4096
这里tensor-model-parallel-size和pipeline-model-parallel-size的乘积就是模型并行使用的GPU数量,再乘以数据并行的组数,就是总GPU数。
显存降下来了但通信上去了,怎么平衡
模型并行本质上是拿通信换显存,切得越细,单卡显存越小,但卡间通信次数越多,如果卡间带宽跟不上,GPU大部分时间都在等数据,实际算力利用率会很难看。
单机多卡建议上有NVLink的机型,北京不少GPU服务器租用商提供NVLink版本,租用价格比普通PCIe机型高出一截,但做张量并行时通信瓶颈明显,这笔钱多数情况下省不得,多机多卡则必须上InfiniBand或者RoCE高速网络,普通千兆以太网基本跑不动大模型并行训练。
两种并行如何组合?大模型训练的真实工作流
实际训练大模型时,几乎没有团队会只用一种并行策略,常见做法是三层并行叠加:数据并行在最外层,负责多机扩展;流水线并行在中间,把模型按层切开;张量并行在最内层,把单层内部切开,这样既能用上几十上百张卡,又能控制单卡显存。
行业共识认为,千亿参数以上模型几乎不可能只用数据并行,必须叠加张量并行与流水线并行,至于具体怎么切,通常要根据模型结构、单卡显存、卡间带宽、机间网络一起测算,没有一套配置能通吃所有场景。
如果只是训练几亿参数的中小模型,老老实实用数据并行就够了,上模型并行反而会因为通信开销把速度拖慢,判断标准很简单:单卡放得下,就数据并行;放不下,再考虑模型并行。
Q&A:数据并行和模型并行常见问题
数据并行和模型并行哪个更适合小模型?
小模型单卡能完整放下时,数据并行是更合适的选择,它实现简单、通信开销低、加速效果直接,模型并行在小模型上反而会因为频繁的卡间通信拖慢训练速度,没有收益。
多卡训练显存不够用模型并行会拖慢速度吗?
会,模型并行降低显存占用的代价是增加通信,如果卡间带宽不足,训练速度可能比单卡还慢,张量并行对带宽要求最高,流水线并行稍低,ZeRO-3在PCIe机器上也会明显掉速,是否划算取决于模型规模和硬件条件。
没有NVLink的普通GPU服务器能做模型并行吗?
可以做流水线并行和ZeRO,但张量并行效率会大幅下降,普通PCIe带宽不足以支撑张量并行每层内部的高频通信,GPU利用率通常上不去,多数情况下流水线并行对带宽的容忍度更高,更适合没有NVLink的机器。