为什么模型服务的蓝绿切换总会抖一下
模型服务的蓝绿切换想做到不中断线上流量,核心不在于“切”这个动作,而在于把“切”拆解成可验证、可回退、可分批的流量迁移过程。
你可能遇到过这种情况:模型刚上线,线上推理延迟突然从50毫秒飙到800毫秒,或者直接报错,明明本地测试一切正常,为什么一上生产就出问题?大多数时候,问题不在代码,而在切换方式。
蓝绿部署的思路很简单:一套蓝色环境跑着旧模型,一套绿色环境跑着新模型,流量从蓝色切到绿色,听起来像一个开关,实际操作却像换一个正在高速运转的轮胎。
AI推理服务 切换 线上环境 的三个核心痛点
有状态服务让切换变成“搬家”
大模型推理服务不是无状态的Web页面,它背后挂着向量数据库、对话历史、用户会话缓存,甚至还有模型自身的KV Cache,你切了流量,但session还留在旧环境里,新环境根本不知道这个用户之前说了什么。
这种情况下,单纯切流量的结果就是:用户感觉“模型失忆了”,对于智能客服这类场景,体验就是灾难性下降。
冷启动时间比想象中长得多
一个百亿参数的模型,加载到GPU显存可能需要几十秒,如果还要加载tokenizer词表、初始化推理引擎、预热显存,整个冷启动时间可能超过三分钟。
据统计,相当一部分线上事故并非模型推理能力不行,而是新环境在流量进入时根本没准备好。 流量进来了,模型还在加载,请求全部超时,最终触发熔断。
新旧模型的输出差异会“吓到”监控系统
新旧两个模型在绝大多数输入上输出一致,但总有一些边缘case结果不同,蓝绿切换的瞬间,监控系统会捕捉到P99延迟波动、错误率飙升,甚至某些输入的输出分布发生变化。
如果监控告警阈值设置得比较敏感,切换动作还没完成,值班同学的手机就被告警轰炸了。
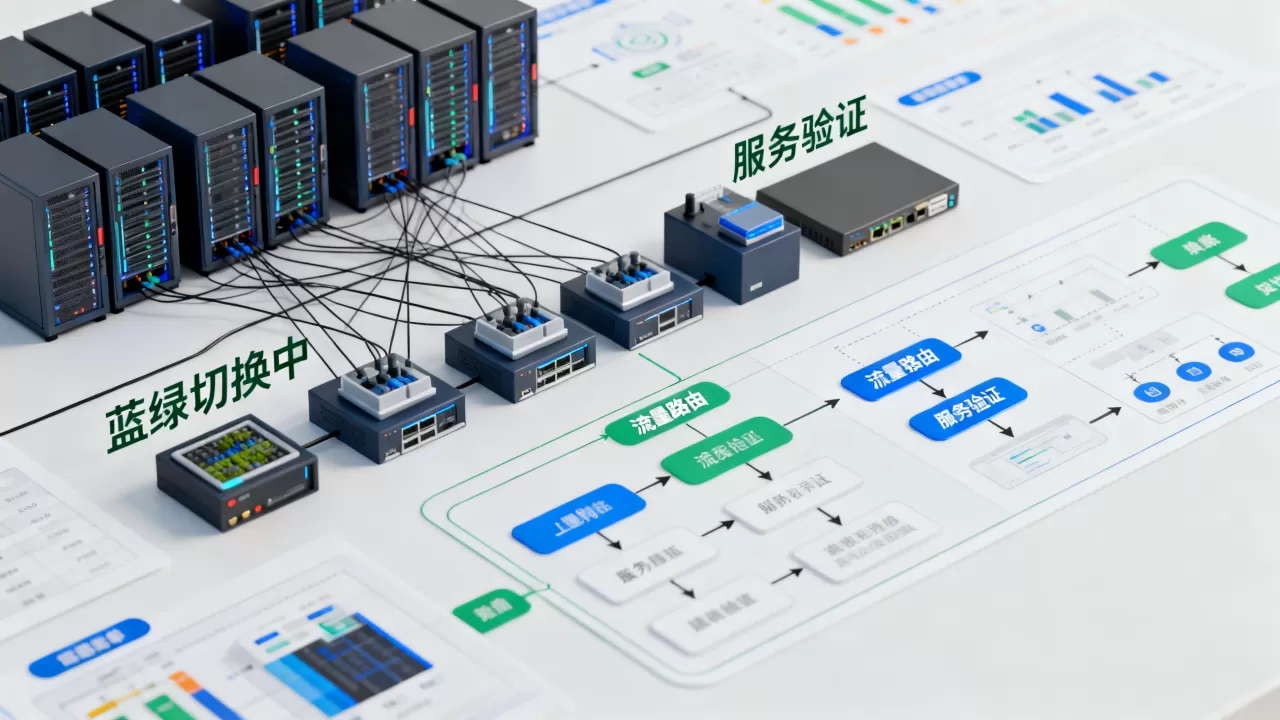
模型上线 流量无损 怎么做:蓝绿切换实操步骤
第一步:绿色环境的“影子接入”
别急着切流量,绿色环境启动后,先让它接收一份线上流量的副本影子流量,生产环境的真实请求复制一份发给绿色环境,但响应不返回给用户,只用来验证。
这一步能解决几个问题:模型是否真的加载成功、推理延迟是否达标、输出格式是否兼容下游系统,影子模式跑几个小时,基本能覆盖掉大部分风险。
第二步:健康检查与预热策略
/healthz接口必须返回真实状态,不是简单返回200就完事,要检查模型是否完成加载、显存是否够用、推理引擎是否正常响应。
推荐做法是给新环境留出“预热时间”,拿一小部分线上请求喂给新模型,让它把常用的推理路径跑热,预热后,P99延迟会稳定在正常水位,这时候再开始切流量,效果会好很多。
第三步:流量权重逐步递增
不要一次性切100%,从5%开始,观察一段时间,确认无误后提升到10%、30%、50%,最后全量。
这里有一个重要的操作细节:流量分配最好在网关层完成,比如Kubernetes的Service、Istio的VirtualService,或者Nginx的upstream配置,以Istio为例,可以在VirtualService里设置weight字段:
- destination:
    host: model-service-blue
  weight: 90
- destination:
    host: model-service-green
  weight: 10
改完配置后,流量平滑过渡,不需要重建Pod,也无需重启服务。
| 切换阶段 | 蓝色权重 | 绿色权重 | 观察时长 |
|---|---|---|---|
| 影子验证 | 100% | 0%(仅副本) | 2-4小时 |
| 灰度导入 | 95% |
5% |
30分钟 |
| 逐步扩容 | 70% | 30% | 1小时 |
| 全量切换 | 0% | 100% | 持续观察 |
第四步:连接排空与优雅下线
蓝色环境接收的流量降到0以后,别急着删,正在处理的请求可能还没结束,长连接也可能还挂着。
行业共识认为,应等待一个“排空窗口”,让旧环境处理完所有在途请求,Kubernetes的terminationGracePeriodSeconds可以设置优雅停机时间,一般建议设置60秒以上。
大模型部署 灰度发布 区别在哪,别把蓝绿当金丝雀
蓝绿和金丝雀经常被混着说,但两者面对的问题不一样。
金丝雀发布是只准备一套新环境,逐步把流量引过去,发现问题就快回滚,蓝绿部署是两套环境同时在线,切换动作干净利落,回滚也简单把流量切回蓝色即可。
对于模型服务,蓝绿部署更实用。 原因是模型推理环境有“权重”状态,新旧两版模型共存时,能快速A/B对比真实效果,金丝雀发布一旦回滚,新环境的模型参数和缓存状态就丢失了,排查问题会很被动。
大模型服务同样需要处理“脏”数据的坑
一个容易忽略的细节:真实线上流量中存在大量脏数据,畸形JSON、超长文本、未知语言、恶意构造的prompt,这些在离线测试里很难覆盖到。
蓝绿切换的优势在于,你可以借着切换的机会,在网关层加入输入校验逻辑,把明显不合规的请求挡在模型之外。
新旧模型的输出不一致问题,推荐用“差异性报告”来量化,跑一批固定的评测集,把新旧模型的输出做diff,人工审核差异较大的case,如果差异集中在不重要的场景,可以继续切换;如果核心能力出现回退,就要暂停。
大模型 线上推理 卡顿或者超时,切换时怎么避开
模型服务的蓝绿切换,最怕的是推理引擎的显存碎片化,老环境跑了一段时间,显存碎片导致可用显存下降,新环境却表现正常,这时候切换流量,容易让人误判新环境比旧环境更优,实际上只是显存状态不同。
建议在切换前,记录两个环境的基础指标:torch.cuda.memory_allocated、max_memory_reserved、推理延迟的P50/P95/P99,以及GPU利用率,比较这些数据时要有统一的参照,避免上下环境评估标准不一致。
业务侧感知不到切换,才算一次成功的蓝绿切换。
对于北京的模型服务团队来说,如果目标是做“模型更新 服务稳定”的发布,蓝绿切换配合影子流量的做法,基本可以解决90%以上的线上事故,云厂商的模型托管服务虽然有生命周期管理功能,但底层的流量调度逻辑,本质上和手动蓝绿部署是一样的逻辑。
Q&A:模型服务切换的关键问题
问:蓝绿切换和灰度发布,哪个更适合模型服务?
蓝绿部署更适合模型迭代,模型服务有“状态”,两套环境都真实运行,可以随时对比效果、快速回滚,金丝雀发布对于无状态微服务很轻量,但模型服务的上下文状态、显存缓存会让回滚变得更复杂。
问:切换时用户会话如何处理才能不中断?
在网关层实现会话亲和,保证同一个用户的请求始终路由到同一个环境,切换时先切新用户流量,老用户等到会话自然过期后再逐步迁移,如果用户的会话必须保证连续,需要将会话状态外部化到Redis,让两个环境的服务都能读取。
问:新模型加载需要三分钟,怎么避免停机等待?
先启动绿色环境,等它完成模型加载和预热后,再开始流量切换,加载期间,蓝色环境照常服务,这也是蓝绿部署相比停机发布最大的优势服务进程不需要退出和重启。