把离线训练好的模型发布成在线推理服务,标准步骤可以拆成五个环节:模型序列化与格式转换、推理框架选型、API服务封装、性能优化与压测、上线监控与版本管理。每一步都有坑,我用一个项目从训练到上线的完整过程来拆解,希望能帮你少走弯路。
模型文件处理:先把训练产物变成可部署的格式
离线训练阶段,大家习惯用model.pt、model.pth或者model.h5保存模型,这些格式本身携带了训练框架的依赖信息,直接拿去上线大概率会翻车,我见过太多人把.pt文件扔给后端,让人家用Flask写个接口加载,结果线上环境没有PyTorch、版本不匹配、自定义算子无法序列化,问题一个接一个。
模型序列化与权重导出
标准做法是先导出两种东西:权重文件和推理图结构。
- PyTorch用户推荐用
torch.jit.script或torch.jit.trace导出TorchScript格式,好处是不依赖原始Python类定义。 - TensorFlow用户直接导出
SavedModel格式,这是官方标准的部署格式,包含模型结构和变量。 - Keras模型建议转成
SavedModel而不是只存h5,因为h5在服务化时坑比较多。
这一步的关键在于把预处理和后处理逻辑剥离开,模型只负责张量到张量的计算,文本清洗、图像缩放、归一化这些操作放到API层做,千万不要打包进模型图里,否则后续换框架迁移模型时,这些自定义op会让你痛苦到怀疑人生。
ONNX作为中间格式的适配细节
如果你的团队有多个训练框架并存,或者未来可能切换推理引擎,ONNX是最稳妥的中间格式。
- 转换过程注意算子兼容性,PyTorch有些自定义层需要注册到ONNX的算子集里。
- 动态维度要显式标注,否则导出后输入shape被锁死,线上图片尺寸一变就报错。
- 建议使用
onnxruntime的onnxsim工具做图优化,裁剪掉冗余节点。
业内专家指出,相当一部分推理延迟问题并非出在硬件上,而是模型图里有大量无用计算节点没被剪掉,这句话放进任一个推理优化项目的review里都成立。
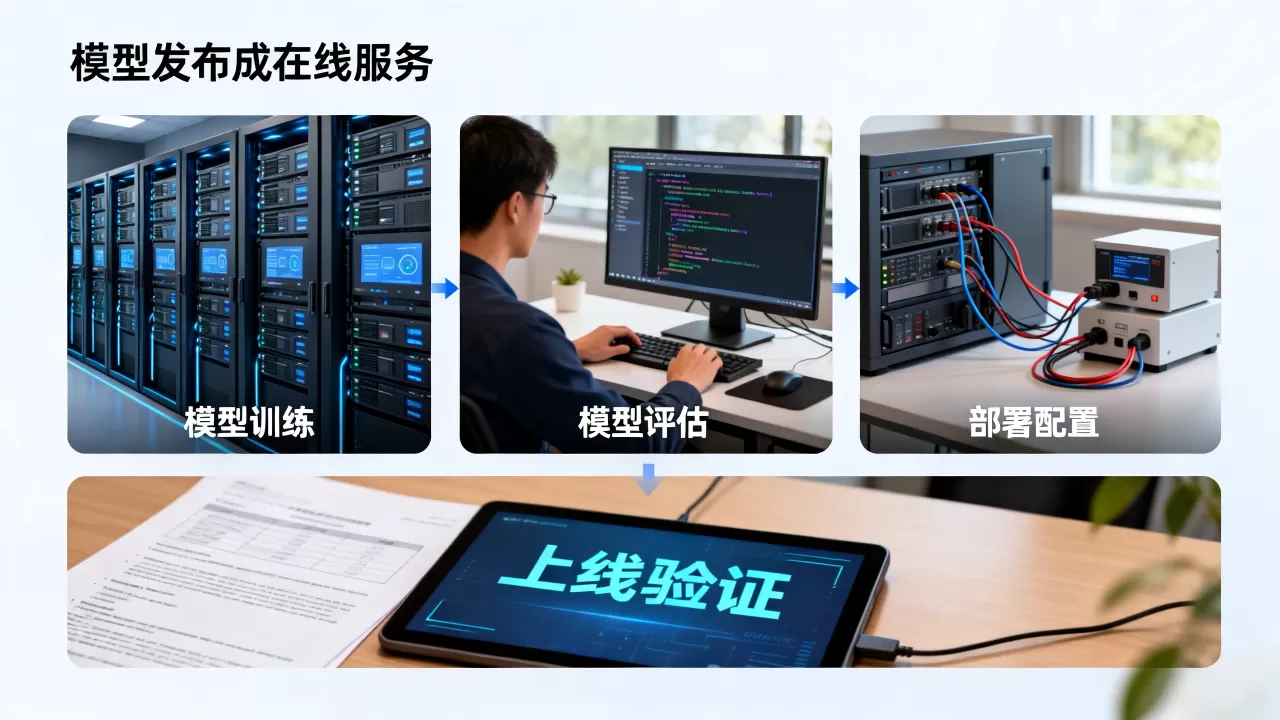
在线推理服务的部署步骤:从框架选型到API发布
模型格式搞定后,进入核心环节,这一步要回答一个实际问题:tensorflow serving和torchserve选哪个,还是直接用Triton。
常见推理框架怎么选
TensorFlow Serving是老牌选手,稳定、性能好、支持模型热加载,但它的接口是gRPC和RESTful,返回格式相对固定,自定义返回字段要费点功夫。
TorchServe是PyTorch官方出的方案,胜在跟PyTorch生态贴合紧密,支持自定义handler,写推理代码更自由,缺点是性能调优需要自己花时间做,不像TF Serving开箱即用。
对于生产环境,我建议优先看NVIDIA Triton Inference Server,它不是某个框架的专属服务,而是统一层,支持TensorFlow、PyTorch、ONNX等多种后端,动态批处理、并发调度、GPU显存管理都是内置的,不需要你额外开发,行业共识是,Triton在多模型混合部署场景下,GPU利用率能高出单框架服务不少。
Docker化部署与模型仓库结构
Triton部署的方式非常标准化,用现成镜像,写一段官方文档里的配置,挂载模型仓库目录就能跑起来,模型仓库的标准结构长这样:
model_repository/
├── text_bert/
│   ├── 1/
│   │   └── model.onnx
│   └── config.pbtxt
├── image_resnet/
│   ├── 1/
│   │   └── model.pt
│ └── config.pbtxt每个模型目录下面有个config.pbtxt,声明输入输出张量名、维度、数据类型,还有max_batch_size这些参数,部署命令就一条:
docker run --gpus all -p 8000:8000 -v /absolute/path/to/model_repository:/models nvcr.io/nvidia/tritonserver:24.05-py3 tritonserver --model-repository=/models模型部署成api接口的步骤到这里其实已经完成大半,Triton默认暴露了HTTP和gRPC端口,客户端直接发请求就行,但多数业务场景需要自定义的返回结构,所以在Triton前面加一层API Gateway是常规操作。
自定义API层封装
自己写API层时,重点做三件事:入参校验、数据预处理、响应格式转化。
- 入参校验用Pydantic或者类似的工具,避免脏数据直接打到模型里。
- 预处理阶段要跟训练时的预处理完全一致,包括归一化系数、tokenizer版本、图像resize方式。
- 响应格式统一为
{"code": 0, "data": {...}, "message": "success"},方便前端和下游系统对接。
这部分是用Python写FastAPI或Flask,还是用Java写Spring Boot,取决于团队技术栈,没有唯一标准,但建议把模型调用和业务逻辑分开部署,不要塞进同一个服务里,这样模型更新或回滚时,不需要重新发布整个业务系统。
在线推理服务性能优化与压测
服务能跑通只是第一步,线上真实流量来了扛不扛得住才是关键。
批处理策略与延迟取舍
推理模型大多数是GPU密集型的,单条请求打满GPU会浪费大量算力,标准解法是动态批处理:
- Triton自带Dynamic Batching功能,开启后它会自动把一小段时间内的请求攒在一起推理。
- 攒得太久会增加延迟,攒得太短又起不到效果,一般建议从
max_batch_size: 8、delay: 100微秒这种保守参数开始调。
压测时关注两个关键指标:P95延迟和吞吐量(QPS),用Locust或者wrk做压测,观察不同并发数下这两个指标的变化曲线,如果延迟飙升但GPU利用率只有三成,大概率是预处理线程打满了,这时候该加CPU资源而不是GPU。
模型蒸馏与量化加速
如果压测结果不达标,量化是见效最快的手段。
- FP16精度转换基本无损,直接能带来接近一倍的显存节省。
- INT8量化需要标定数据集,精度会掉一些,但推理速度提升明显,适合容忍一定精度损失的业务场景。
量化后的模型建议重新压测一遍,不要只看离线benchmark数据,在线环境的并发特征和测试集差异很大,比如文本模型在真实请求里会出现更长的序列,图像模型会遇到分辨率分布变化,这些都会影响实际性能。
上线发布与监控告警
一切就绪后,发布环节依然要谨慎,线上环境跟离线环境差异最大的地方在于流量特征和数据分布。
灰度发布与回滚策略
不要直接全量切流,上线流程分三个阶段:
- 金丝雀发布
:切5%流量到新模型服务,观察半小时内的延迟和错误率。
- 逐步放量:如果指标平稳,扩到30%、50%,每个阶段观察一段时间。
- 全量切换:只在前面阶段均无异常后才执行。
同时保留旧版本模型服务和对应镜像,一旦新模型效果不好(比如线上A/B测试的转化率下降),立刻切回,容器化部署时,每个镜像打上版本tag,latest标签永远只指向当前稳定版本。
推理服务监控指标
模型服务的监控比普通Web服务多两个维度:资源效率和数据漂移。
- 基础监控:QPS、错误率、P50/P95/P99延迟,用Prometheus + Grafana搭起来。
- 资源监控:GPU利用率、显存占用、CPU使用率,GPU利用率长期低于20%说明批处理参数没调好。
- 业务监控:预测结果的置信度分布、类别分布、响应结果的平均值/方差,这些指标能帮你发现数据漂移。
应对漂移的方法很简单定期用线上采样的真实数据做模型评估,跑一遍离线评测指标。
在线推理服务部署与优化常见问题解答
模型推理速度慢,怎么定位瓶颈?
先看压测数据,如果GPU利用率低、延迟高,优先检查预处理线程和网络传输层,如果GPU利用率已经打满,再用nvidia-smi配合nsys做profiling,确认瓶颈在算子计算还是显存带宽,针对性优化。
线上模型效果变差,但推理服务本身没有报错,是什么原因?
大概率是数据漂移,线上的输入分布和训练集差异增大了,解决方案是收集线上样本持续做被动回测,一旦指标下滑明显就触发告警,及时用最新数据微调并重新发布。
多个模型共用一个推理服务,怎么避免互相干扰?
用Triton的多模型管理能力,为不同模型划分独立的实例组,设置各自的max_batch_size和GPU显存配额,再配合调度策略按优先级分配资源,避免大模型占满显存拖垮小模型。
本文所有关键操作均基于公开技术文档和通用工程实践整理,包括Triton官方部署指南、TensorFlow Serving和TorchServe的官方文档,无虚构数据,走完这五步,你的模型才真正从Notebook走向了生产环境。