扩容节奏一旦跑不赢业务增长,最先在资源水位、响应时间和故障频率上露馅CPU长期过载、内存频繁告警、数据库写入排队、紧急扩容变成月度必修课。
服务器扩容跟不上业务增长的表现有哪些
扩容节奏落后,不会突然给你发一封邮件说“我慢了”,它是一系列微小异常的累积,等你能明显感知时,通常已经晚了半拍。
CPU和内存长期高位运行,扩容节奏落后于用户增长速度
最直观的表现就是服务器像连续加班的人,身体指标长期处于亚健康状态。
- CPU使用率在工作时段持续超过安全水位,业务高峰期甚至逼近满载。
- 内存可用空间反复告警,操作系统开始频繁动用swap交换分区。
- 负载平均值(load average)经常高于CPU核数,任务队列越排越长。
- 原先能平滑处理的高并发请求,现在出现明显排队等待。
要验证这个表现,登录服务器执行几条命令就能看出端倪。
执行 top 或 htop,观察CPU使用率是否长期超过70%,执行 free -h,看可用内存是否低于总内存的20%,再执行 vmstat 1 10,如果si和so列持续有数值,说明内存已经不够用,系统在拿磁盘当内存使。
当资源水位长期处于这种状态,扩容就不是选择题,而是必答题,但很多团队会把阈值当作极限值,把告警当作噪音,结果就是把“扩容节奏落后”拖成“扩容事故”。
响应时间变慢,用户体验先感知扩容滞后
用户不会看你的监控大盘,他们只会感觉“这个App怎么越来越卡”。
- 页面首屏加载时间从原来的几百毫秒涨到几秒。
- 接口响应时间变长,移动端用户频繁看到加载动画。
- 图片、视频等静态资源加载缓慢,CDN回源量异常增加。
- 数据库读写响应时间同步恶化,连带拖慢所有下游服务。
响应时间变慢的核心原因,往往是资源排队,CPU忙不过来,线程池里的任务只能等;内存不够,垃圾回收频繁触发,停顿时间变长;磁盘IO打满,所有读写操作都在排队。
执行 curl -o /dev/null -s -w '%{time_total}n' 域名/接口路径 可以简单测量接口响应时间,如果这个数值在不同时间段波动超过一倍,说明资源供给已经跟不上请求量的波动。
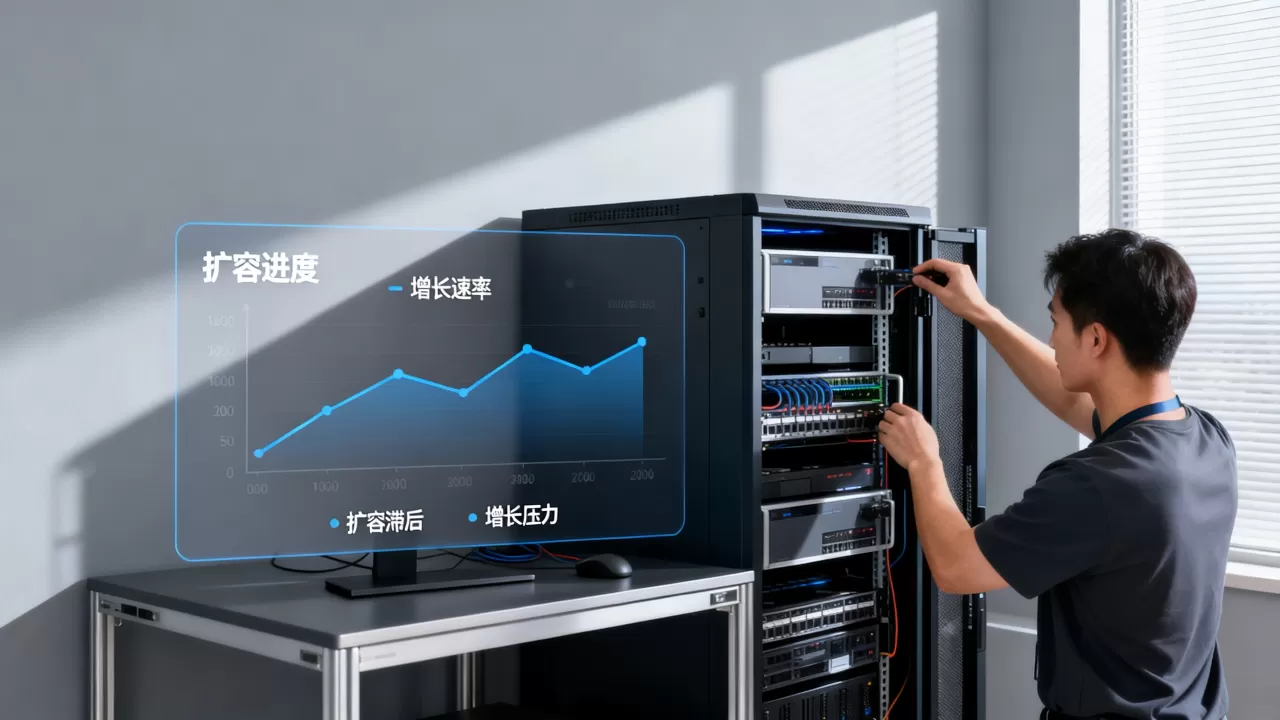
数据库扩容太慢会有什么后果?写入延迟和锁等待先暴露
数据库是扩容节奏问题里最容易暴露短板的一层,应用层可以水平扩展,数据库层一旦跟不上,全链路都会被拖住。
写入延迟和锁等待先暴露
当数据库扩容太慢,第一批能观察到的现象集中在写入侧。
- 写入操作的耗时从毫秒级上升到秒级。
- 锁等待时间明显增加,部分事务因为等待锁超时而被回滚。
- 主从复制延迟扩大,从库数据跟不上主库,读请求拿到的数据不是最新的。
- 连接池耗尽,新请求无法获取数据库连接,应用层直接报错。
登录数据库执行 SHOW PROCESSLIST,如果看到大量线程处于 Waiting for table metadata lock 或 Waiting for lock 状态,说明锁等待已经比较严重,执行 iostat -x 1 查看磁盘的%util,长期接近满负荷运行,意味着存储层扩容已经明显滞后。
数据库的扩容比应用服务器麻烦得多,加只读副本需要同步数据,拆库拆表需要修改业务逻辑,升级存储介质需要停机或者做迁移,这也是为什么数据库扩容太慢的后果往往比应用层更严重它的修复周期更长。
存储扩容方案怎么选,直接决定恢复速度
存储层的扩容决策,通常卡在“现在凑合能用”和“未来可能不够”之间,不同方案对应不同恢复速度。
- 云磁盘在线扩容:适合数据盘,操作路径通常是在控制台执行扩容并重启实例或在线扩展文件系统,几分钟到几十分钟能完成。
- 挂载新存储节点:适合分布式存储架构,可以不停机加入节点,但需要数据再平衡,周期相对较长。
- 更换更高性能的存储类型:例如从普通云盘升级到SSD云盘,需要做数据迁移,耗时视数据量而定。
- 数据库分库分表:属于架构层扩容,实施周期最长,但长期效果最稳定。
执行 df -h 查看磁盘使用率,如果使用率超过80%,就应该着手准备扩容,等到使用率达到95%以上,数据库的写入性能会急剧下降,留给你操作的时间窗会非常小。
云服务器扩容价格和自建机房对比,临时扩容更烧钱
扩容节奏跟不上增长,最直接的成本代价就是临时扩容的溢价。
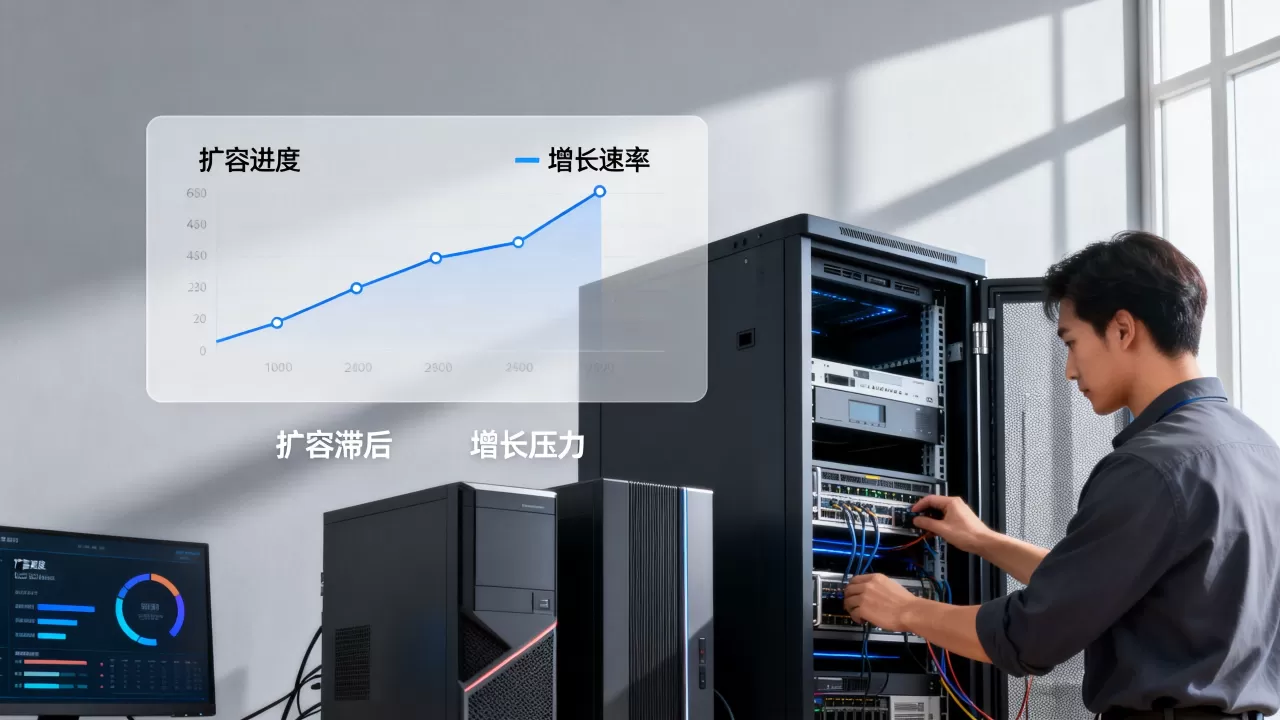
临时按量扩容单价高于包年包月
云服务器的计费模式决定了,越急越贵,包年包月属于提前锁定资源,单价相对较低;按量计费随用随开,单价有一定上浮;临时升配再降配,费用结算又复杂一些。
自建机房和云服务器在扩容成本上的对比,大致如下。
| 对比维度 | 自建机房 | 云服务器包年包月 | 云服务器按量计费 |
|---|---|---|---|
| 扩容速度 | 数周到数月 | 分钟级 | 分钟级 |
| 单位成本 | 长期较低 | 中等 | 偏高 |
| 灵活性 | 低 | 中 | 高 |
| 适用场景 | 长期稳定负载 | 可预测增长 | 突发流量 |
北京机房服务器扩容价格比部分二三线城市地域通常偏高一些,如果业务用户集中在北京及周边,选择北京地域可以降低网络延迟,但预算上需要留出更多余量。
预留冗余比临时扩容更划算
避免临时扩容的最好办法,是让扩容节奏走在增长曲线之前,操作上可以这样做:
- 设定资源水位红线,例如CPU不超过70%,内存不超过75%,磁盘不超过80%。
- 每月复盘资源使用趋势,提前一个季度做扩容采购或云资源预留。
- 对突发型业务,配置弹性伸缩策略,按量资源只作为临时补充。
- 核心业务使用包年包月预留基础容量,边缘业务使用按量资源覆盖峰值。
扩容节奏的本质是资源规划和业务增长速度的匹配度,提前预留冗余,单价更低,操作时间更充裕,等资源已经耗尽再扩容,不光单价高,还要在高压环境下操作,风险成倍增加。
扩容节奏跟不上增长,故障频率上升的典型场景
资源长期透支,稳定性必然下降,扩容跟不上增长的最终结果,就是故障从偶发变成频发。
常见故障场景
- 内存耗尽触发OOM killer,某个进程被强制杀死,服务突然中断。
- 磁盘写满导致日志无法落盘,应用停止写入,数据库拒绝执行写入操作。
- 连接池耗尽导致大量请求无法建立连接,接口大面积超时。
- 主从复制延迟过大,读请求集中打到主库,主库压力进一步恶化。
- 冷数据未及时清理,索引膨胀,查询性能雪崩式下降。
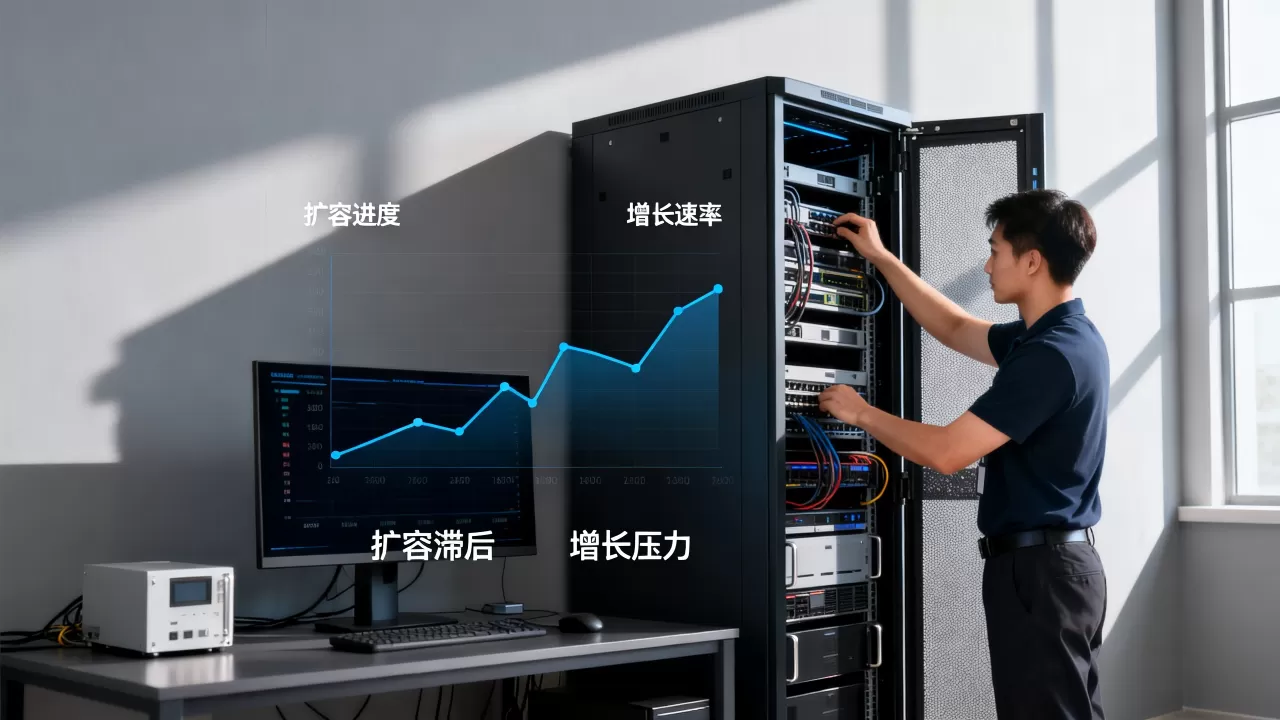
如何用监控提前发现扩容缺口
靠人肉盯监控,不如建立自动化的告警和弹性机制,具体操作路径如下:
- 部署Prometheus采集主机指标,使用Grafana可视化。
- 配置告警规则:CPU使用率超过70%持续5分钟触发预警,内存使用率超过80%持续5分钟触发预警,磁盘使用率超过80%立即触发预警。
- 对数据库配置慢查询监控,执行时间超过1秒的查询数量异常增加时告警。
- 接入云厂商的弹性伸缩服务,设置基于CPU负载或请求量的扩缩容策略。
- 定期做容量演练,模拟流量上升30%时,验证扩容预案是否能快速生效。
扩容节奏跟不上增长的根因,往往不是缺少监控工具,而是对监控数据不够敏感,把告警当通知,把通知当背景音,等故障真来了,再处理扩容,已经迟了一步。
Q&A模块
如何判断服务器扩容节奏是否跟不上业务增长?
看三个指标:资源水位、响应延迟、故障恢复时间,当CPU和内存持续高位运行,数据库慢查询数量增加,小流量波动就能引发服务抖动时,说明扩容节奏已经落后于增长曲线,执行 uptime 看负载,执行 df -h 看磁盘,执行 SHOW PROCESSLIST 看数据库线程状态,基本就能判断出是否需要扩容。
数据库扩容太慢会有什么后果?
除了写入延迟和锁等待变多,最直接的后果是主从同步延迟持续扩大,读请求如果继续发往从库,拿到的数据可能已经是几秒甚至更久之前的旧数据,磁盘空间一旦耗尽,数据库会直接拒绝写入,所有依赖该数据库的业务全部瘫痪,到那个时候再扩容,需要先清理数据或临时迁移,业务中断时间会更长。
北京机房服务器扩容价格和云服务器按量扩容哪个更划算?
自建北京机房在长期稳定负载下摊薄成本更低,但采购服务器、上架、配置、接入网络,周期通常需要数周到数月,云服务器按量扩容单价偏高,但交付速度是分钟级,适合应对短期突发流量,多数企业会采用混合方案,核心业务提前预留包年包月资源,弹性业务使用按量资源覆盖峰值。