割接窗口放在业务低峰并留出观察期,本质是用时间换安全把系统切换的风险压在用户几乎无感知的时段,再用一段静默监测把延迟暴露的故障兜在手里。
割接窗口为什么必须贴着业务低峰走
割接不是把设备关掉再打开那么简单,它是把正在运行的生产系统切换到新版本、新设备或新链路上的过程,中间任何一步配置偏差、脚本报错、依赖冲突,都可能直接变成线上事故,把割接窗口塞进业务低峰,不是工程师喜欢熬夜,而是因为低峰期天然提供了一张安全网。
业务低峰期割接和高峰期割接的区别在哪里
二者最核心的区别不是操作步骤不同,而是故障爆炸半径完全不同,高峰期割接就像在早高峰的主干道上换红绿灯控制器,一旦失灵,后面堵成什么样完全不可控,低峰期割接则类似凌晨封路施工,即便某个步骤出错,受影响的车流也相当有限。
| 对比维度 | 低峰期割接 | 高峰期割接 |
|---|---|---|
| 在线用户体量 | 较少 | 较大 |
| 故障感知面 | 多数用户无感 | 大量用户直接报障 |
| 回退允许时间 | 相对从容 | 极其紧张 |
| 团队心理压力 | 可控 | 极大 |
| 业务补偿成本 | 较低 | 往往很高 |
业内专家指出,割接窗口选择的底层逻辑是把“无法消除的风险”转移到“业务代价最小的时点”,系统切换必然有不确定性,但把不确定性和用户高峰叠加,等于主动放大事故概率。
割接窗口一般放在几点比较合适?业务低峰怎么定
不同行业的低峰时段差异很大,不能照搬一个固定时间,银行核心系统多数在凌晨1点到4点,因为夜间联机交易最少;电商大促系统反而要避开零点秒杀高峰,选择凌晨3点到5点;政务系统常用周六夜间到周日凌晨,因为周末办事流量天然走低。
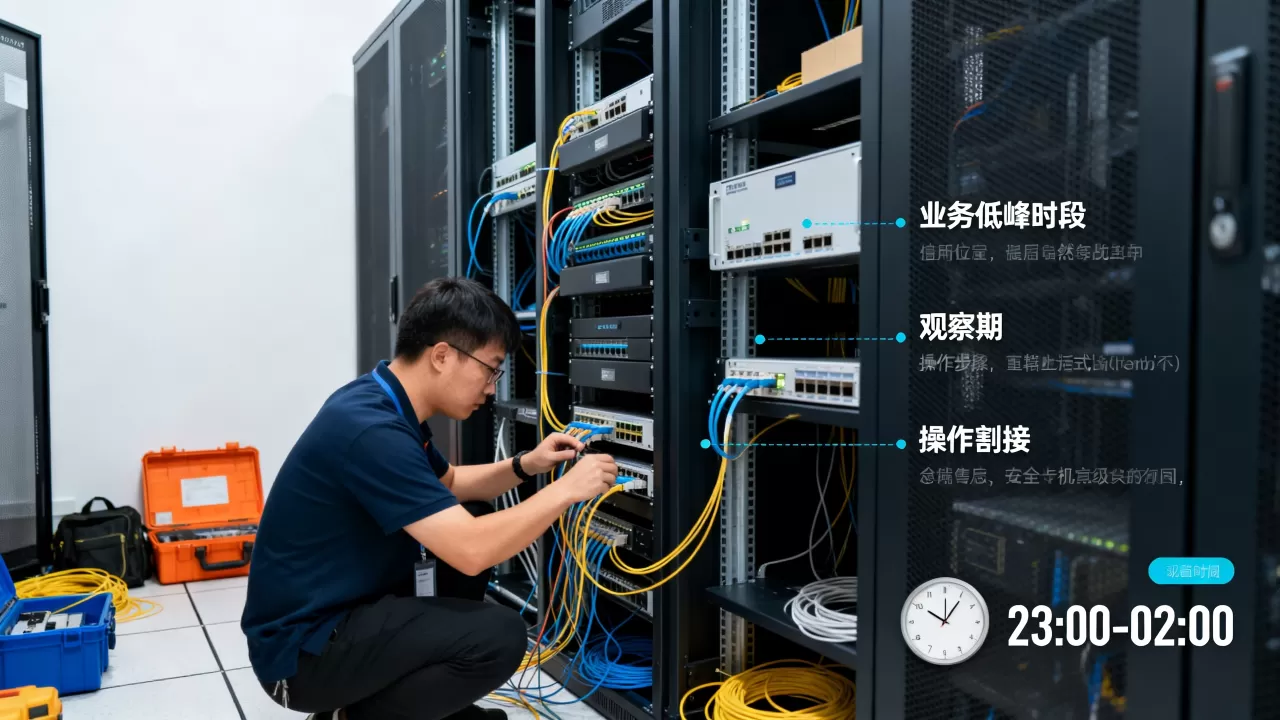
判断低峰不能拍脑袋,要用数据说话,实操路径可以这样走:
- 从监控系统导出最近四周的业务请求量、并发连接数、交易流水,按每15分钟一个采样点统计。
- 计算每天24小时的分位数,找到连续四周都处于最低水平的时间段。
- 叠加批处理任务窗口,避开日切、跑批、备份、数据同步等内部高峰。
- 确认该时段内没有外部定投、对账、清算等定时业务触发。
- 最终把割接开始时间定在低峰区间前半小时,留出操作准备和变更单核对时间。
例如使用crontab -l查看服务器定时任务分布,再结合netstat -an | grep ESTABLISHED | wc -l观察连接数走势,就能避开多数系统内部忙碌点。
留观察期:不是“切完没事”就算成功
割接完成只代表变更动作执行结束,不代表系统真的稳定,很多问题有延迟暴露特性,比如缓存预热不完整、连接池泄漏、定时任务未触发、下游对账延迟报错等,如果切完直接解散,等问题冒出来时往往已经错过最佳处置窗口。
行业共识认为,割接观察期至少应覆盖一个完整的业务起伏周期,如果系统白天有交易高峰,观察期最好延到第二天业务平稳后,只守着屏幕看十几分钟没有报错,这种观察基本属于自我安慰。
割接后观察期要多久才够用
观察期长度取决于系统复杂度和变更范围,参考行业常见做法:
- 网络链路割接:30分钟到2小时,重点看丢包率、延迟、路由收敛。
- 应用发布割接:2小时到6小时,重点看错误率、响应时间、发布后的首次流量冲击。
- 数据库迁移割接:6小时到24小时,重点看慢查询、数据一致性、备份恢复可用性。
- 核心系统整体切换:至少一个完整业务日,要覆盖日切批处理、对账、日报生成等环节。
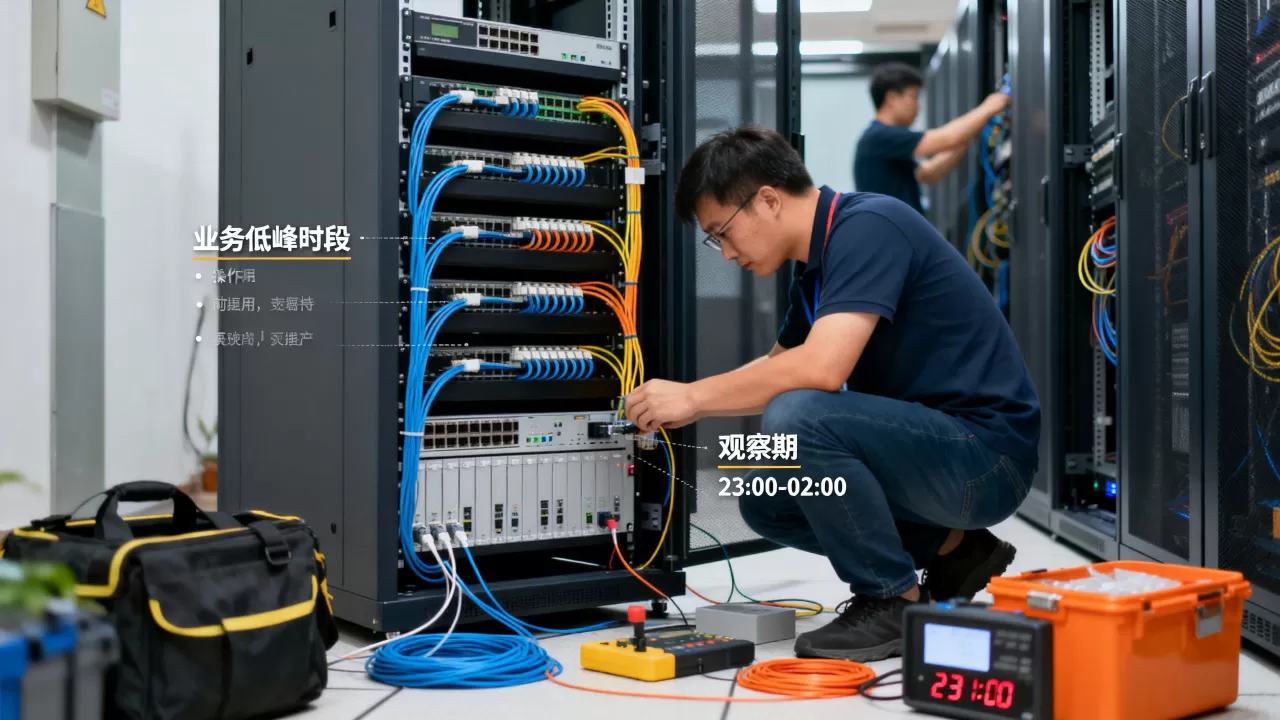
观察期内不要急着关闭变更窗口,保持回退方案可用,保持原环境数据完整,保持相关工程师在线,很多运维团队吃过亏:切完看到绿灯就回去睡觉,结果凌晨跑批任务全部失败,第二天早上才发现。
观察期内必须盯住的几个指标
观察期不是干等,要按清单逐项核对,可执行的步骤大致如下:
- 打开应用日志,执行
tail -f /var/log/应用.log | grep -i error,看有无持续异常。 - 检查数据库慢查询,使用
mysqldumpslow -s c -t 10查看新出现的慢SQL。 - 观察消息队列积压,例如
kafka-consumer-groups --bootstrap-server localhost:9092 --describe --group 消费组名。 - 对照割接前保留的关键业务报表,确认订单量、支付成功率、接口调用量没有异常波动。
- 主动执行一次冒烟测试,模拟真实用户访问核心交易链路。
- 检查监控面板中的CPU、内存、磁盘IO、连接数是否回到正常区间。
如果观察期内任何一个指标出现异常,应在回退窗口内果断执行回退,回退不是失败,是把风险控制住。
割接窗口的成本与地域差异
有人会问,把割接放在凌晨,人工成本和机房夜间服务费会不会更高?确实,不少一线城市的IDC夜间施工报价比白天高,但这笔支出和高峰期割接导致的事故赔偿、用户流失、品牌损伤相比,多数情况下可以忽略,割接窗口放在业务低峰,本质上是一种性价比极高的风险对冲。
不同地域的割接时间安排也有差异,比如上海数据中心割接时间安排通常要考虑金融交易时段,因为大量支付机构和银行核心系统部署在沪上机房,凌晨2点到4点是相对稳定的维护空窗,北京、深圳等城市的互联网公司则更倾向凌晨3点到5点,避开晚高峰和早间定时任务,机房割接收费标准一般会区分工作日夜间、节假日夜间和应急变更,夜间服务费通常包含工程师驻场、工具租赁和备用设备费用,报价差异较大,具体需要根据机房等级和变更范围评估。
但无论地域和价格怎么变,核心原则不会变:用低流量时段换取更长的排错时间,用观察期换取更早的故障发现。
把割接窗口放在低峰并留观察期的落地清单
落地执行可以按下面的顺序走,每个节点都留记录:
- 提前确定业务低峰期:用监控数据说话,不靠经验猜。
- 发布变更通知:告知客服、业务方、值班群组。
- 准备割接脚本和回退方案:每一条变更命令都要有对应的回退命令。
- 割接前快照:数据库备份、配置备份、路由表备份。
- 进入低峰窗口后执行割接:按步骤执行,每一步确认输出结果。
- 割接完成后进入观察期:盯指标、查日志、跑冒烟。
- 观察期结束形成复盘:记录实际耗时、异常情况、可改进项。
留观察期这件事,最大的价值不是发现所有问题,而是给团队留出一条“来得及处理”的时间线,凌晨割接、清晨复盘、白天平稳,才是割接窗口设计的正确姿势。
割接窗口相关问题解答
割接窗口一般放在几点比较合适
不同业务低峰时段不同,银行系统多数在凌晨1点到4点,电商系统常用凌晨3点到5点,政务系统多用周六夜间,判断标准不是固定时间,而是连续四周的流量最低区间。
业务低峰期割接和高峰期割接的区别是什么
核心区别在于故障影响范围和回退压力,低峰期割接受影响用户数少,即使失败也有足够时间回退;高峰期割接一旦出现问题,大量用户实时感知,业务补偿和客诉处理成本极高。
割接后观察期要多久才能发现隐藏问题
一般至少覆盖一个完整的业务起伏周期,网络割接观察30分钟到2小时,应用发布观察2小时到6小时,数据库迁移观察6小时到24小时,核心系统切换建议观察一个完整业务日,覆盖日切批处理和对账环节后确认无异常再关闭变更窗口。