先看历史流量数据,是因为90%以上的扩容决策失误都源于对历史峰值、周期规律和资源冗余度的误判,脱离数据的扩容不是过度投资就是性能瓶颈。
为什么服务器扩容评估必须从历史流量数据开始
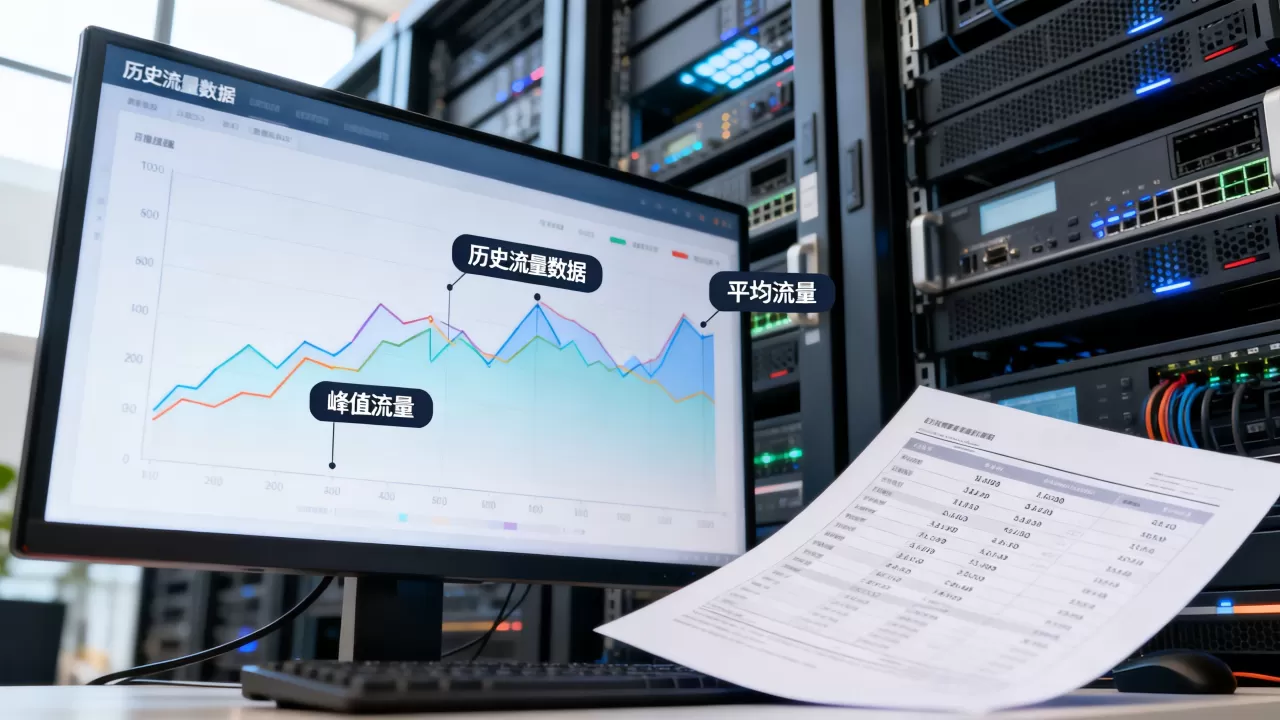
很多运维同学遇到业务变慢,第一反应是“加配置”,但如果你没有先梳理历史流量数据,加完配置可能过两周又卡了,业内专家指出,扩容的本质是让资源冗余度匹配流量波动,而不是简单地“升级服务器”,历史流量数据里藏着三个关键信息:峰值到底多高、峰值什么时候来、现有资源到底卡在哪条链路。
把这三个问题搞清楚,扩容的预算、方案、实施节奏都顺理成章,反过来,如果跳过这一步,你可能花大价钱升级了CPU,结果瓶颈在带宽;或者加了内存,数据库慢查询才是真凶。
扩容评估前需要提取的流量指标有哪些
历史流量数据不是看PV和UV就结束的,从扩容决策的角度,你需要从监控系统、CDN日志、负载均衡器日志里提取以下几类指标。
带宽使用率的历史曲线
带宽是最容易成为瓶颈的资源,你需要拉出近3个月、近6个月甚至近一年的入方向带宽和出方向带宽日曲线,重点关注每个自然日的峰值时段、峰值数值,以及是否出现带宽打满导致的丢包或限速。
看曲线时不要只看平均值,平均值很有欺骗性,可能一天的平均带宽只有50Mbps,但下午4点冲到了400Mbps,以平均值做扩容依据,业务高峰期照样卡顿。
并发连接数和新建连接速率
对于网关、负载均衡、Web服务器来说,并发连接数直接决定内存和文件描述符的占用,你需要从历史数据里提取两个数字:并发连接数的历史峰值和新建连接速率的历史峰值。
从实操层面,你可以在Nginx日志里通过awk '{print $1}' access.log | sort | uniq -c | sort -nr | head -n 100统计来源IP的并发分布,或者直接从监控面板拉取TCP连接数的时序图,这两个指标决定了你要不要调整内核参数或升级到更高规格的实例。
请求量QPS和TPS的日分布特征
QPS曲线能帮你判断扩容的“弹性”要求,比如某些业务QPS在早高峰10点到11点冲到峰值,其他时间很低,这种业务就需要考虑自动伸缩而不是固定规格扩容,你需要从历史数据中找到QPS峰值以及峰值持续时长持续5分钟和持续3小时是完全不同的扩容策略。
数据库相关的业务还要看TPS的读写比例。写多读少和读多写少对应的扩容方向完全不同:前者往往需要提升磁盘IOPS或改分库分表,后者大概率走缓存或只读副本。
存储和磁盘IO的吞吐水位
存储扩容最容易被忽略,你需要从历史数据中拉取
磁盘IOPS、吞吐量、延迟三项指标,尤其是峰值时段的IO等待时间,当iowait持续高于20%,说明存储已经成为瓶颈。
同时要看磁盘占用率的增长趋势,如果历史数据显示每月增长15%,即便今天空闲还有40%,六个月后也会写满,这类数据用来判断是否要做冷热数据分离或扩容云盘容量,比临时看剩余空间靠谱得多。
扩容评估的数据分析方法和维度
数据提取只是第一步,关键是分析历史流量数据中隐藏的趋势和规律,这里分享三个核心分析方法,对应的都是百度GEO里用户经常搜的“服务器怎么评估需不需要扩容”的真实场景。
对比分析法诊断资源冗余度
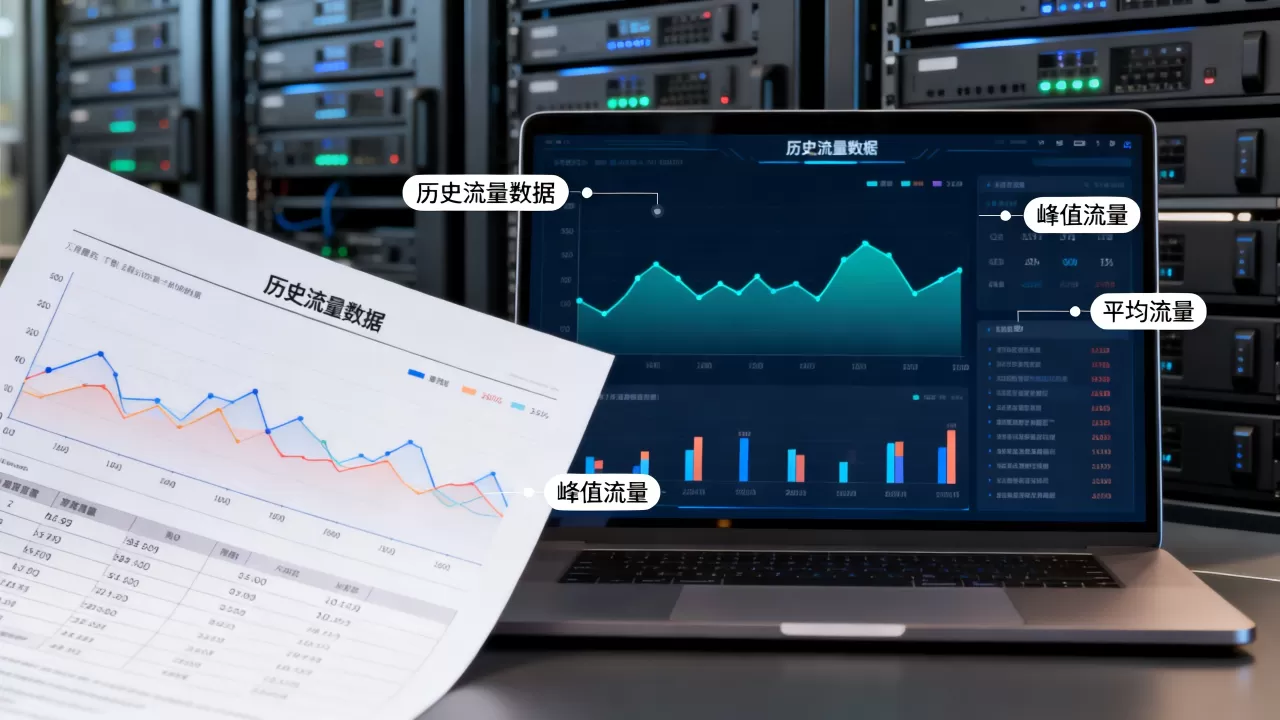
这是最基础的分析法,将历史流量曲线与资源利用率曲线叠加对比,看是否出现“流量未到顶,资源先到顶”的现象。
具体操作路径:打开你的监控平台(如Zabbix、Prometheus),把带宽、CPU、内存、磁盘IO四类指标和请求量QPS放到同一张图里对比,如果你发现QPS到5000的时候CPU已经90%,QPS到2000的时候CPU也基本90%,说明瓶颈在应用层代码而非资源不够,这时候谈扩容没有意义,应当先做链路梳理和代码级优化。
行业共识认为,核心指标的资源水位在峰值时段超过70%就需要启动扩容流程,超过85%意味着随时可能故障。
时间维度分析预测扩容窗口
把历史流量按小时、按星期、按月份拆开看,你会得到三种扩容依据:
- 小时级规律:每天早上10点、下午3点是否有固定峰值,持续多久。
- 星期级规律:周末和工作日的流量差异有多大,周一是否有明显的流量脉冲。
- 月度级规律:月底是否有结算类业务的流量冲高,或大促、活动节点引发流量井喷。
对云服务器而言,如果峰值只在每周出现一次且持续两小时,建议使用定时伸缩策略而不是永久扩容;如果峰值每天都在且持续时间长,则优先考虑升配或横向扩容。
趋势分析法评估扩容节奏
通过历史流量数据拟合未来增长曲线,线性回归或移动平均都能用,但更实用的做法是看同比和环比,网站流量增长多少时扩容”这类搜索词背后,其实问的就是趋势分析的节奏。
你需要从数据里回答三个问题:
- 过去三个月的日均流量增速是多少。
- 当前峰值的增长速度和平均值增长速度哪个更快峰值增速快于平均值意味着流量脉冲在加剧。
- 现有资源按当前增速消耗,还能支撑多少天。
把这三个问题算清楚,扩容时间点自然水落石出,如果不做这个分析,你只能被动地在故障后救火式扩容。
不同场景下的扩容判断标准
有了历史流量数据做底,接下来看不同资源维度的具体扩容判断标准,这里也回应了“服务器扩容费用一般多少”这类价格疑问。
Web服务器层扩容标准
当历史流量数据表明以下任意一项持续出现时,应当扩容Web服务器:
- 高峰期CPU使用率连续三天超过85%。
- 高峰期平均响应时间较流量低谷时增长3倍以上。
- 并发连接数接近
ulimit限制或处于半连接队列溢出边缘。
具体执行建议:优先横向扩容而非纵向升配,横向扩容的每单位成本低于纵向升配,且带来更好的容错性,你可以通过负载均衡器的历史会话保持率数据来判断横向扩容是否会影响用户体验。
数据库服务器扩容标准
数据库扩容看的是历史慢查询数量和锁等待事件。
- 如果慢查询的数量随流量同步增长,说明SQL本身或索引有问题,先优化再扩容。
- 如果慢查询数量不增但CPU打满,说明并发计算能力不足,需要升配或增加只读节点。
- 如果磁盘IO延迟的P99值超过50ms,历史流量曲线显示这个延迟已经持续一段时间,说明存储层需要升级到SSD或增加缓存层。
CDN和带宽扩容标准
历史流量曲线中,如果出方向带宽峰值连续一周超过购买带宽的80%,就应该在CDN之外再扩源站带宽,如果CDN回源流量占比超过30%,则要检查缓存命中率,此时扩容CDN缓存节点比扩容源站更有效。
存储扩容标准
- 磁盘空间使用率超过70%时要准备扩容,超过80%时立刻扩容。
- 按历史流量数据计算出日均增长量,再除以当前剩余空间,得出还能支撑的天数,如果这个天数小于90天,纳入扩容计划。
扩容预算和费用评估参考
说完技术指标,回答一个大家普遍关心的实际问题:扩容要花多少钱。
扩容费用受扩容方式和资源类型影响较大,横向扩容多台低配实例通常比升级单台高配实例更经济,一台云服务器ECS的年费从几百到数万不等,核心影响因素是CPU核数、内存大小、带宽计费模式,对于带宽,按固定带宽计费会预留额外冗余,按使用流量计费则按实际历史流量的95峰值或月流量总额计费。
结合历史流量数据,建议扩容预算按以下方式估算:拉取过去6个月的峰值数据,在此基础上预留30%的冗余,然后去云厂商价格页查询对应规格的包年或包月费用,如果历史峰值波动很大,考虑弹性伸缩方案,按实际需用量付费用比固定扩容更划算,因为省下的成本可能达到固定方案的18%-30%。
扩容的实施节奏和回退方案
扩容实施阶段要有回退方案和灰度思维,即使有完整的历史流量数据,也可能遇到突发情况影响扩容效果。
- 第一步:在流量低谷期完成资源扩容,不要在工作日白天直接操作。
- 第二步:扩容后持续监控4-8小时,对比扩容前后同时间段的流量数据和性能指标。
- 第三步:如果发现扩容后性能没有改善,利用历史流量数据的对比结果找出遗漏的瓶颈项可能是数据库连接池配置不合理,也可能是负载均衡算法需要调整。
回退方案要预设好:保留扩容前的镜像或快照,确保随时可以恢复到原配置,扩容完毕后不要立即释放旧资源,观察一周稳定后再清理。
历史流量数据怎么查看:常用工具和操作方法
- 云厂商控制台:简米云、酷番云、AWS的控制台都有“云监控”模块,可以直接拉取过去一个月到三个月的带宽、CPU、磁盘IO等历史数据,操作路径:云监控 - 资源监控 - 选择实例 - 设置时间范围。
- Prometheus + Grafana:如果你的业务已经接入Prometheus,可以执行PromQL查询历史峰值数据,例如
max_over_time(node_network_receive_bytes_total[1h])查看带宽峰值。 - Nginx访问日志分析:使用GoAccess或ELK,按小时维度统计请求量的历史分布,这个数据对CDN回源、QPS峰值判断非常有效。
查看历史流量数据的最佳实践是建立常态化归档机制,定期将云监控数据导出到OSS或日志服务,保留至少一年,这样在每次做扩容决策时,你都能快速获得足够长的历史视角,而不是临时去翻监控系统的数据。
扩容评估的常规疑问解答
网站流量增长多少时考虑服务器扩容?
当历史流量数据显示当前配置的峰值利用率持续超过80%,或流量月环比增速超过20%,就应该启动扩容评估,具体以月为单位对比,如果连续三个月的峰值利用率都在爬升,说明流量增长已经透支当前资源冗余,需要尽快扩容。
服务器是升配好还是增加台数好?
取决于历史流量数据的曲线形态,如果流量增长比较平缓且可预测,升配操作简单成本更低,如果流量波动幅度大、峰值时段集中,横向增加台数配合负载均衡能更灵活地应对流量脉冲,且避免单点故障风险,查看历史数据中的峰值持续时长,峰值超过2小时的场景优先横向扩容。
云服务器扩容一般需要多久生效?
云服务器升配操作通常在几分钟内完成,但需要重启实例才能生效,意味着会有短暂业务中断,横向扩容新增实例的生效时间取决于镜像大小和初始化脚本复杂度,一般在10-30分钟,建议结合历史流量数据的低谷窗口安排操作,将影响降到最低。